시스템 · 서버핵심 · 17분 읽기
정방향·역방향 프록시와 캐시
프록시가 누구를 대신해 요청을 전달하는지 구분하면 접근 제어, TLS 종료, 캐시와 실제 클라이언트 주소를 이해하기 쉽습니다.
개념부터 찾아보기
정의·역할·동작 원리를 독립 페이지에서 확인하세요. 본문의 밑줄 용어에도 설명이 있습니다.


이 노트에서 설명할 수 있게 되는 것
- 클라이언트 연결과 upstream 연결의 독립성을 설명한다.
- 프록시 체인에서 신뢰할 전달 헤더의 범위를 판정한다.
- 캐시 적중·원본 오류·시간 초과를 구분한다.
먼저 알면 좋은 개념Apache·Nginx와 웹 서버 운영
01포워드 프록시와 리버스 프록시가 대리하는 쪽
- 는 클라이언트가 외부 서비스에 접근할 때 선택하는 중계 지점이다.
- 접근 정책·출발지 통합·캐시 등을 제공할 수 있다.
- 서비스 진입점는 서버 측 진입점으로 동작하며 클라이언트는 그 주소를 서비스의 주소로 사용한다.
- 백엔드 선택내부 서버 위치를 숨기고 요청 경로에 따라 적절한 백엔드로 전달할 수 있다. 두 역할 모두 중계지만 구성 주체와 요청 대상의 선택 방식이 다르다.
- 앞뒤 연결의 분리는 보통 클라이언트 연결과 백엔드 연결을 별도로 관리한다.
- 중계와 HTTP 처리클라이언트 연결의 바이트를 한 네트워크 선처럼 그대로 이어 놓는 것과 HTTP를 해석해 새 요청을 만드는 것은 다르다.
- ·프록시 종료 지점이 프록시라면 클라이언트 구간 암호화는 그곳에서 끝나고, 백엔드 구간을 다시 HTTPS로 보호할지는 별도 연결 설정이다.
- 프록시클라이언트용 프록시를 인증 없이 외부에 개방하면 의도하지 않은 중계 경로가 될 수 있다. 역방향 프록시도 허용할 호스트와 경로, 대상 서버를 명확히 제한해야 한다.
02proxy_pass가 URI와 헤더를 바꾸는 방법
- URI가 있는 의 location /api/에서 http://127.0.0.1:8000/처럼 URI /를 포함하면 정규화된 요청 URI 중 location에 대응하는 부분을 지정 URI로 대체하는 형태가 된다.
- /api/items는 백엔드의 /items가 될 수 있다.
- URI 없는 반면 http://127.0.0.1:8000처럼 URI 부분을 생략하면 일반적인 경우 요청 URI를 그대로 전달하므로 /api/items가 유지된다.
- URI 치환의 예외 location·rewrite·변수 사용에는 별도 규칙이 있어 단순 예를 무조건 확장하지 않는다.
- HostHost는 백엔드가 가상 호스트를 고르거나 절대 URL을 만들 때 의미가 있고 X-Forwarded-Proto는 원래 접속 스킴을 전달하는 관례다.
- X-Forwarded-ForX-Forwarded-For에는 여러 프록시 경유 정보가 쌓일 수 있다.
- 헤더애플리케이션이 임의 클라이언트가 보낸 헤더를 그대로 신뢰하면 주소·스킴 위조가 가능하므로 프록시가 덮어쓰거나 검증하고 앱은 신뢰한 중계 지점에서 온 정보만 해석해야 한다.
location /api/ {
    proxy_pass http://127.0.0.1:8000/;
    proxy_set_header Host $host;
    proxy_set_header X-Forwarded-Proto $scheme;
    proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
}
교육용 예시. 결과와 주소는 설명용이며 실제 시스템에서 실행한 기록이 아니다.
LEARN THROUGH PRACTICE
proxy_pass의 URI 유무로 백엔드 요청 경로 비교하기
upstream 선택과 URI 치환을 분리하여 같은 클라이언트 요청이 백엔드에 어떤 경로로 전달되는지 계산한다.
실습 구성과 전제
- 세 사진은 upstream 구성과 서로 다른 설정 예시다. 두 location 설정을 동시에 적용한 단일 서버 결과가 아니다.
- 일반적인 prefix location을 다룬다. location·변수 기반 ·rewrite가 섞인 경우는 별도 규칙을 확인해야 한다.
upstream은 목적 서버 집합을 정의한다
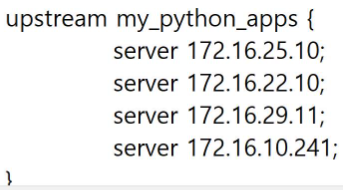
- 사진의 upstream에는 네 서버가 나열되고 에서 그 그룹 이름을 사용한다. 그룹 선택은 목적 백엔드에 관한 것이며 URI 경로 치환 자체와는 구별된다.
- 서버에 포트를 생략한 이 HTTP 설정은 기본 80을 사용한다. 각 서버가 실제 어떤 경로에 응답하는지는 애플리케이션 설정과 요청 로그로 확인해야 한다.
 원본 크기로 보기 ↗
- upstream my_python_apps 블록에 네 server 행이 나열된다.
- 각 server 행에는 주소가 있고 별도 포트가 표시되지 않는다.
확인 기준그룹에 등록되었다는 사실만으로 각 서버가 정상이라고 단정하지 않는다. 구성과 실제 연결·응답을 대조한다.
URI 없는 proxy_pass는 기존 경로를 전달한다
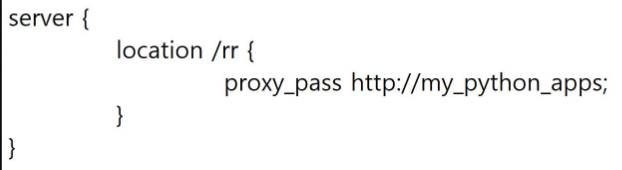
- 첫 location 예시는 /에 대해 http://my_python_apps;를 사용한다. URI를 붙이지 않은 이 단순 구성에서 //item?x=1 요청은 백엔드에도 //item?x=1로 전달된다.
- 일반 prefix /는 //뿐 아니라 /rrx 같은 문자열에도 맞을 수 있다. 경로 경계를 원한다면 trailing slash와 별도 exact location 설계를 고려한다.
 원본 크기로 보기 ↗
- location /rr 블록 안의 proxy_pass는 upstream 이름 뒤 곧바로 세미콜론으로 끝난다.
- upstream 주소 뒤에 /haha 같은 URI 부분이 없다는 것이 다음 사진과의 차이다.
확인 기준백엔드 404가 나오면 연결 실패로 단정하기 전에 백엔드가 받은 경로를 확인한다.
URI가 있으면 일치한 prefix를 치환한다
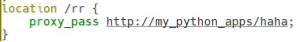
- 다음 사진의 는 /haha를 붙인다. 일반 prefix /에 //item?x=1이 들어오면 일치한 / 부분을 /haha로 바꾼 /haha/item?x=1이 전달되는 구성을 읽을 수 있다.
- 슬래시 한 개도 결과 경로에 영향을 준다. 재구성 예시처럼 location //와 /api/를 짝지으면 //item이 /api/item으로 매핑된다.
location /rr/ {
    proxy_pass http://lab_backend/api/;
}
재구성 예시: //item?x=1 → /api/item?x=1. lab_backend는 준비한 upstream 이름이다.
 원본 크기로 보기 ↗
- proxy_pass의 upstream 뒤에 /haha가 추가되어 있다.
- location은 앞 사진처럼 /rr이므로 목적 서버 집합보다 URI 치환 여부가 핵심 차이다.
확인 기준쿼리 문자열·정규화·rewrite 등 추가 설정이 없다면 계산한 경로를 백엔드 접근 로그에서 확인한다.
실습에서 확인한 동작 원리
- upstream은 서버 집합을, 의 URI 부분은 전달 경로의 치환을 결정한다.
- 프록시 앞의 URL과 백엔드 접근 로그를 연결하면 정상 연결 뒤 404가 발생하는 이유를 설명할 수 있다.
설정·출력 추가로 확인하기 12장
아래 화면을 펼쳐 위 실습의 설정값, 명령과 확인 기준을 비교해 보세요. 각 묶음은 별도 실습 기록입니다.
실습 화면 묶음 01 10장
 원본 크기로 보기 ↗
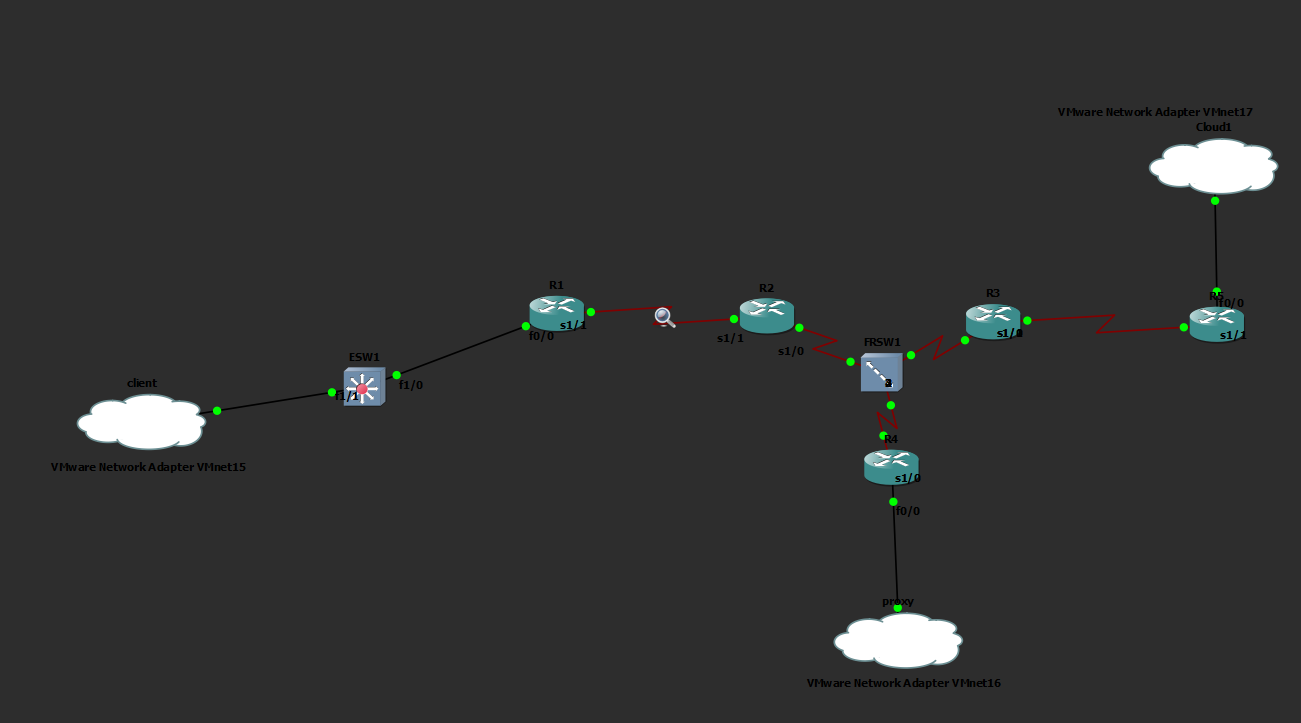
- 문서 문맥에 삽입된 원본 실습·개념 참고 화면이다. 정방향·역방향 프록시와 캐시 학습 내용과 함께 당시 구성·설정·관찰 결과를 비교할 수 있다.
 원본 크기로 보기 ↗
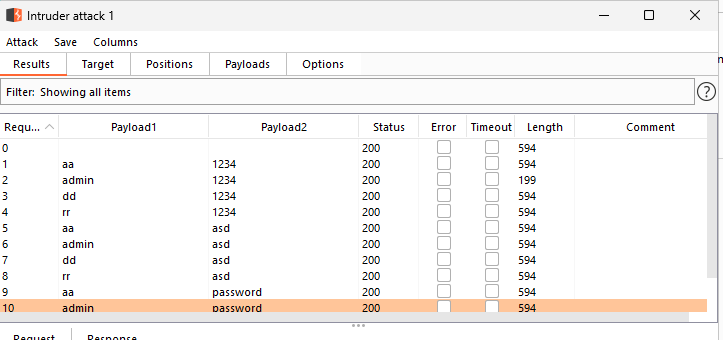
- 「시나리오2 (다른 flask + html 서버 로그인)」 문맥에 삽입된 원본 실습·개념 참고 화면이다. 정방향·역방향 프록시와 캐시 학습 내용과 함께 당시 구성·설정·관찰 결과를 비교할 수 있다.
 원본 크기로 보기 ↗
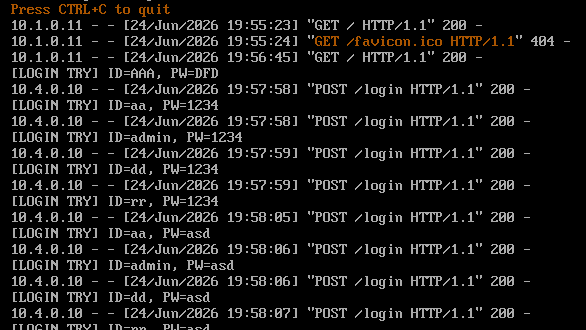
- 「시나리오2 (다른 flask + html 서버 로그인)」 문맥에 삽입된 원본 실습·개념 참고 화면이다. 정방향·역방향 프록시와 캐시 학습 내용과 함께 당시 구성·설정·관찰 결과를 비교할 수 있다.
 원본 크기로 보기 ↗
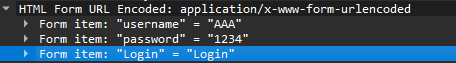
- 「전체 사진」 문맥에 삽입된 원본 실습·개념 참고 화면이다. 정방향·역방향 프록시와 캐시 학습 내용과 함께 당시 구성·설정·관찰 결과를 비교할 수 있다.
 원본 크기로 보기 ↗
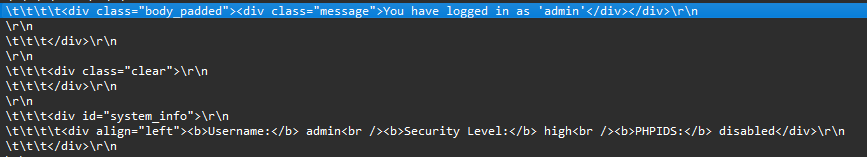
- 「전체 사진」 문맥에 삽입된 원본 실습·개념 참고 화면이다. 정방향·역방향 프록시와 캐시 학습 내용과 함께 당시 구성·설정·관찰 결과를 비교할 수 있다.
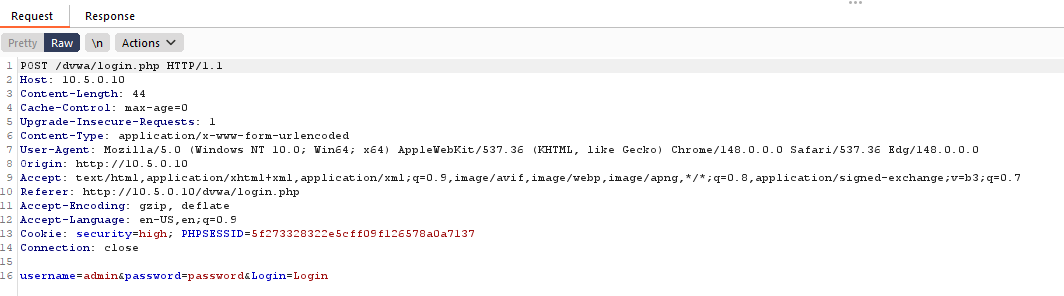 원본 크기로 보기 ↗
- 「proxy 서버」 문맥에 삽입된 원본 실습·개념 참고 화면이다. 정방향·역방향 프록시와 캐시 학습 내용과 함께 당시 구성·설정·관찰 결과를 비교할 수 있다.
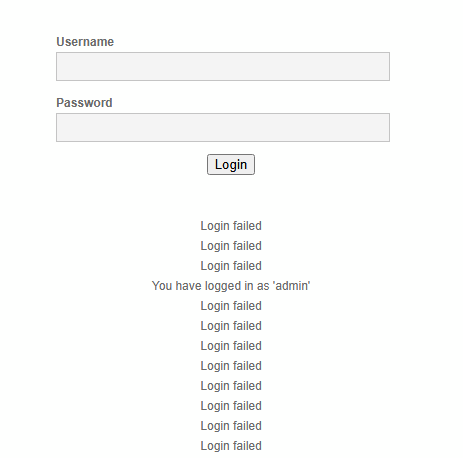 원본 크기로 보기 ↗
- 「시나리오 1 (프록시 서버에서 broute force attack)」 문맥에 삽입된 원본 실습·개념 참고 화면이다. 정방향·역방향 프록시와 캐시 학습 내용과 함께 당시 구성·설정·관찰 결과를 비교할 수 있다.
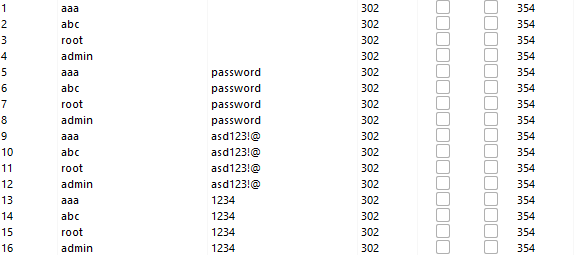 원본 크기로 보기 ↗
- 「시나리오 1 (프록시 서버에서 broute force attack)」 문맥에 삽입된 원본 실습·개념 참고 화면이다. 정방향·역방향 프록시와 캐시 학습 내용과 함께 당시 구성·설정·관찰 결과를 비교할 수 있다.
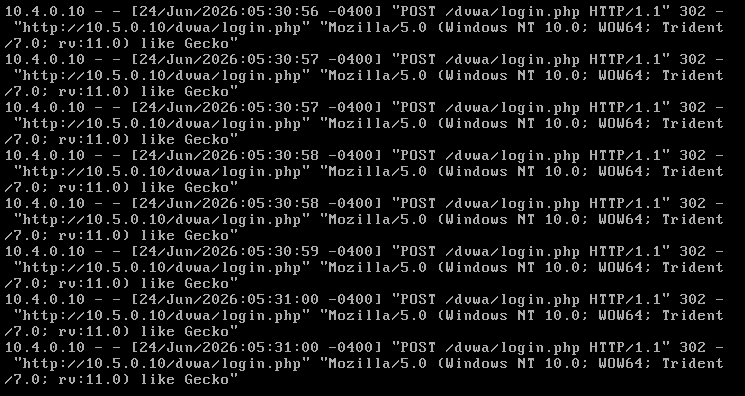 원본 크기로 보기 ↗
- 「시나리오 1 (프록시 서버에서 broute force attack)」 문맥에 삽입된 원본 실습·개념 참고 화면이다. 정방향·역방향 프록시와 캐시 학습 내용과 함께 당시 구성·설정·관찰 결과를 비교할 수 있다.
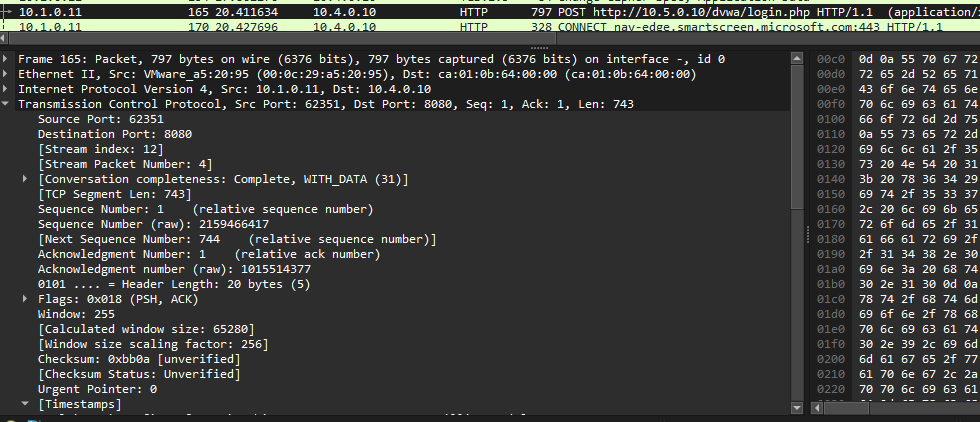 원본 크기로 보기 ↗
- 「전체 사진」 문맥에 삽입된 원본 패킷 캡처이다. 정방향·역방향 프록시와 캐시 학습 내용과 함께 당시 구성·설정·관찰 결과를 비교할 수 있다.
실습 화면 묶음 02 1장
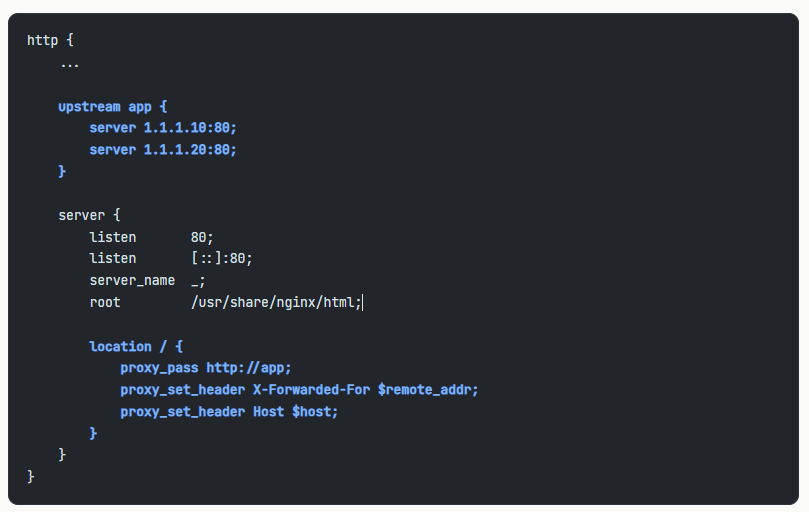 원본 크기로 보기 ↗
- 에 삽입된 원본 학습 화면이다. Nginx의 upstream 서버 목록과 proxy_pass·전달 헤더를 설정한 코드 화면이다. 인접 문서는 HAProxy와의 구성 비교를 다루지만, 화면에 보이는 문법은 Nginx 설정이다.
실습 화면 묶음 03 1장
 원본 크기로 보기 ↗
- 학습 원본 · 역방향 프록시 경로 전달의 해당 절에 수록된 화면·도식이다.
동작·명령 참고 문서
03연결 재사용·버퍼·timeout의 서로 다른 시간
- 백엔드 프록시는 백엔드 연결을 유지해 다음 요청에 재사용할 수 있다.
- 이는 클라이언트 keep-alive와 별도 연결 풀이다.
- 응답·버퍼응답 버퍼링을 사용하면 백엔드의 응답을 프록시가 받아 저장하면서 느린 클라이언트에 전달할 수 있어 백엔드 연결 점유와 클라이언트 전송을 분리한다.
- 반대로 스트리밍 이벤트에서는 즉시 전달과 버퍼 설정의 관계가 중요하다.
- timeout은 백엔드 연결 수립 대기, 은 백엔드 응답 읽기의 대기 조건과 관련되며 많은 구현에서 전체 요청의 절대 총시간이 아니라 연속 읽기 사이의 시간이다.
- 응답오류 502는 유효한 백엔드 응답을 받지 못한 경우, 504는 중계 중 시간 초과를 나타낼 수 있다.
- timeout·요청원인 없이 timeout을 늘리면 느린 요청을 더 오래 점유하게 할 뿐 처리 능력을 늘리지 못한다.
- 요청·응답요청 본문 크기, 연결 제한, 응답 시간 제한, 스트리밍과 WebSocket 같은 기능은 서비스 요구에 맞게 맞춰야 한다.
- 계층별 제한 불일치프록시와 애플리케이션의 제한이 다르면 일부 요청만 실패하는 현상이 나타난다.
원리 심화
04프록시 버퍼와 timeout은 어느 구간을 제한하는가
- 두 연결의 독립성클라이언트→프록시와 프록시→upstream은 별도 연결이다. 한쪽의 keep-alive··접속 종료가 다른 쪽의 모든 상태와 일대일로 같지는 않다.
- 응답 버퍼버퍼링을 켜면 프록시가 upstream 응답을 받아 메모리와 설정상 임시 파일에 보관하면서 느린 클라이언트에 전달할 수 있다. 저장 자원과 upstream 점유 시간의 교환 관계다.
- 버퍼링을 끈 경우응답을 받는 대로 전달하면 느린 소비자의 영향이 upstream 읽기 속도에 더 직접적으로 전달될 수 있다. 스트리밍의 지연 요구와 연결 점유 비용을 함께 본다.
- 연결 수립 제한은 upstream 등의 접속 단계와 관계한다. 연결이 끝난 뒤 앱이 응답을 늦게 만드는 시간 전체를 같은 값 하나로 제어하지 않는다.
- proxy_read_timeout은 두 연속 읽기 사이의 무응답 간격을 제한한다. 응답 전체가 시작부터 끝날 때까지 반드시 그 시간 안에 완료돼야 한다는 총 기한은 아니다.
예제로 추적
055초 read timeout에서 12초 응답이 성공하는 조건
- 가상 조건proxy_read_timeout=5s이고 upstream 연결은 이미 완료됐다고 가정한다. 서버가 t=0,4,8,12초에 응답 데이터를 보내고 마지막에 종료한다.
- 간격 계산연속 데이터 도착 사이가 각각 4초이므로 이 이상화한 사례는 5초의 읽기 간격 제한을 넘지 않는다. 전체 12초라는 이유만으로 이 설정이 자동 만료되는 것은 아니다.
- 멈춤의 분기t=4초 이후 다음 바이트가 t=10초까지 오지 않으면 6초 공백이 생긴다. 약 5초의 무응답 시점에 timeout 조건에 걸릴 수 있다.
- 연결 오류와 구별아예 upstream 연결을 못 맺은 경우에는 위 읽기 시간선을 시작하지 못한다. 단계의 실패와 앱의 긴 응답 간격을 로그에서 분리한다.
- 앱의 완료 여부클라이언트가 timeout을 받아도 upstream 업무가 이미 실행됐을 수 있다. 동일 POST를 곧바로 재전송하면 중복 상태 변경이 생길 수 있어 요청 식별·현재 상태 확인이 필요하다.
| 응답 도착 시각 | 직전 도착과 간격 | 5초 제한 |
|---|---|---|
| 0→4→8→12초 | 매번 4초 | 이 조건만으로는 만료 아님 |
| 0→4→10초 | 마지막 6초 | 무응답 제한 초과 가능 |
검증·예외
06캐시·헤더·upstream 로그에서 원인 분리하기
- HIT의 경계캐시 HIT에서는 해당 요청에 대해 upstream을 새로 호출하지 않을 수 있다. 앱 로그가 없다는 사실을 곧바로 수집 장애로 판단하지 않는다.
- 키의 구성Host·URI·인증 상태·Vary 등의 차이를 캐시 키와 정책에 반영하지 않으면 서로 다른 사용자가 같은 객체로 취급될 수 있다. 사용자별 응답은 공유 캐시 적용 조건이 중요하다.
- 오류의 발생지프록시가 만든 502/504와 앱이 반환한 같은 숫자의 응답은 발생 주체가 다를 수 있다. access/error 로그와 upstream 상태·주소·시간을 연결한다.
- 클라이언트 주소upstream의 상대는 프록시일 수 있다. 신뢰한 프록시가 정리한 전달 헤더만 실제 출발지의 보조 근거로 사용하며 외부 입력 헤더를 그대로 신뢰하지 않는다.
- 재시도의 범위다른 backend로 재시도할 때 앞선 backend의 실제 처리 여부가 모호할 수 있다. 조회 요청과 중복 효과가 있는 요청에 같은 재시도 가정을 적용하지 않는다.
07캐시 hit·miss·재검증을 하나의 요청으로 추적하기
- 캐시·Host캐시 키가 Host·Path·Query 등 요청의 구분 요소를 포함한다고 하자.
- Cache miss 처리첫 요청이 miss이면 원본 서버에서 응답을 받아 저장 가능한지 정책을 평가한다.
- 요청·응답다음 요청의 키가 같고 저장 응답이 fresh이면 원본에 가지 않고 응답할 수 있다.
- ETagfreshness가 끝나도 ETag나 Last-Modified 같은 validator가 있으면 조건부 요청으로 변경 여부를 확인한다.
- 원본이 304를 반환하면 기존 본문을 재사용할 수 있다.
- Cache-ControlCache-Control: no-store는 저장하지 않도록 요구한다.
- no-cacheno-cache는 항상 저장 금지라는 뜻이 아니라 재사용 전에 검증을 요구하는 의미다.
- Vary·요청Vary는 특정 요청 헤더 값에 따라 표현이 달라짐을 알려 주며 캐시는 해당 변형을 구분해야 한다.
- 개인화 응답의 공유 위험사용자별 비공개 응답을 공용 키 하나로 저장하면 성능은 좋아 보여도 다른 사용자에게 정보가 노출될 수 있다.
- 캐시purge·만료·bypass는 서로 다른 캐시 생애 동작이다.
- 오래된 응답 허용 정책장애 시 오래된 응답을 사용할지와 그 허용 기간도 정책으로 정한다.
- 캐시·응답캐시 적중률뿐 아니라 응답 최신성, 원본 오류와 캐시 자체의 오류를 구분할 관찰 정보가 필요하다.
08로드 밸런싱·캐시·엣지의 조합과 상태 위치
- 부하 분산부하 분산은 여러 백엔드 중 하나를 선택하는 역할이다.
- 는 부하 분산 없이 단일 서버로만 전달할 수 있고, 캐시 없이 와 만 처리할 수도 있다.
- CDNCDN 같은 엣지 네트워크는 사용자와 가까운 위치에 응답·계산·보안 기능을 배치하며 캐시는 그 기능 중 하나다.
- 같은 장비에 여러 역할이 있어도 용어의 목적은 분리해야 한다.
- 애플리케이션 상태 위치요청을 여러 앱에 나누면 ·업로드 파일·DB 의 상태가 어디 있는지가 중요해진다.
- 요청·세션한 서버 메모리에만 로그인 상태가 있으면 다음 요청이 다른 서버로 갈 때 세션이 사라진 것처럼 보일 수 있다.
- sticky sticky 은 선택을 묶는 수단이지만 해당 서버 고장 때 상태를 복제해 주지는 않는다.
- 요청·저장 경로 설계정상 요청 경로와 상태 저장 경로를 함께 설명해야 프록시 확대가 서비스 확장으로 이어진다.
09프록시 앞뒤에서 달라지는 연결 정보
- 프록시·역방향 프록시 앞에서 가 종료되는 구성을 생각한다.
- 두 구간의 연결클라이언트는 프록시와 연결하고 프록시는 별도의 연결로 애플리케이션 서버에 요청을 보낸다.
- 내부 연결이 HTTP인지 HTTPS인지는 별도 설정이다.
- 전달 헤더의 신뢰 경계애플리케이션 소켓이 직접 보는 연결 상대는 보통 프록시이므로 원래 사용자 주소·호스트·프로토콜이 필요한 경우 정의된 전달 정보를 이용한다. 단, 그 정보는 외부 사용자가 임의로 보낸 값과 신뢰된 프록시가 생성한 값을 구분해야 한다.
- X-Forwarded-For클라이언트가 X-Forwarded-For에 임의의 주소를 넣은 채 요청할 수 있다고 가정한다.
- 위조된 주소 헤더프록시가 이를 검증 없이 넘기고 애플리케이션이 첫 값을 무조건 사용자 주소로 믿으면 로그와 접근 판단을 왜곡할 수 있다.
- 프록시·헤더각 프록시가 기존 헤더를 제거·교체·추가하는 규칙과 애플리케이션이 신뢰하는 홉의 범위를 함께 정해야 한다.
- 헤더어떤 단일 헤더 이름을 쓰느냐보다 실제 배치와 신뢰 경계를 일치시키는 것이 중요하다.
- HTTPS 요청프록시와 를 맺고 HTTP 요청을 전달한다.
- 헤더·허용된 사이트와 경로를 선택하고 전달 헤더를 신뢰 정책에 맞게 정리한다.
- 별도 upstream 요청설정된 내부 주소와 프로토콜로 새 요청을 보낸다.
- 응답 반환업무 결과 또는 오류를 프록시에 반환한다.
- 응답 전달정책에 따라 헤더·캐시 처리를 하고 클라이언트에 돌려준다.
설명과 함께 보는 보조 도식
메시지 순서
TLS 종료 후 upstream으로 전달하기
단일 신뢰 프록시를 둔 사례다. 실제 전달 헤더 정책은 구성에 맞게 결정한다.
01
HTTPS 요청
프록시와 TLS를 맺고 HTTP 요청을 전달한다.
- 외부 구간
- TLS 보호
전체 단계를 한 번에 읽기
- 01
HTTPS 요청
프록시와 TLS를 맺고 HTTP 요청을 전달한다.
- 외부 구간
- TLS 보호
- 02
헤더·경로 정책
허용된 사이트와 경로를 선택하고 전달 헤더를 신뢰 정책에 맞게 정리한다.
- 신뢰 주체
- 프록시가 확인한 연결 정보
- 03
별도 upstream 요청
설정된 내부 주소와 프로토콜로 새 요청을 보낸다.
- 내부 암호화
- 별도 설정 필요
- 04
응답 반환
업무 결과 또는 오류를 프록시에 반환한다.
- 애플리케이션 연결 상대
- 프록시
- 05
응답 전달
정책에 따라 헤더·캐시 처리를 하고 클라이언트에 돌려준다.
- 연결
- 앞뒤 연결은 별개
10캐시와 오류가 응답을 바꾸는 지점
- 프록시프록시 접근 로그와 애플리케이션 로그의 요청 수가 다른 것은 캐시·차단·연결 실패 때문일 수 있다.
- upstreamupstream 연결 실패, 연결은 됐지만 응답이 늦은 경우, 본문 전송 중 끊긴 경우를 분리한다.
- 응답·요청시간 제한은 연결·응답·전체 요청 중 어떤 범위에 적용되는지 확인해야 한다.
- Timeout과 자원 점유504가 보인다는 이유로 값을 크게 늘리면 느린 요청이 자원을 더 오래 점유할 수 있다. 요청 식별자와 각 계층의 소요 시간을 연결해 실제 병목을 찾는다.
| 구성·관찰 대상 | 관찰 내용 | 해석 |
|---|---|---|
| 외부 연결 | ·요청 호스트 | 클라이언트와 프록시 사이 문제 |
| upstream 연결 | 주소·프로토콜·시간 제한 | 내부 연결·응답 실패 |
| 전달 헤더 | 생성·덮어쓰기·신뢰 홉 | 주소 위조·잘못된 리다이렉트 |
| 캐시 | 키·적중·우회 조건 | 개인화 응답 공유·오래된 내용 |
학습 확인
이해했는지 확인하기
- 프록시가 클라이언트와 서버 중 누구를 대리하는지 설명한다.
- TLS 종료 이후 구간과 전달 헤더의 신뢰 범위를 확인한다.
- 개인화 응답의 캐시 조건을 확인한다.