역방향 프록시와 캐시
Reverse Proxy · 리버스 프록시
역방향 프록시는 클라이언트 요청을 서버 쪽에서 받아 뒤쪽 애플리케이션으로 전달하고 결과를 돌려주는 중계 계층이다. 포워드 프록시가 클라이언트의 외부 접근을 대리하는 것과 역할이 다르며 캐시··부하 분산을 함께 구성할 수 있다.
밑줄 용어에 마우스를 올리거나, 키보드로 선택하거나, 터치하면 설명을 볼 수 있습니다.
01무엇이고, 어떤 일을 하나
- 공개 접점과 내부 애플리케이션의 주소·프로토콜을 분리한다.
- 헤더·URI·시간 제한·버퍼 정책을 적용하며 요청을 중계한다.
- 캐시 가능한 응답을 재사용하여 원본 서버의 처리량을 줄인다.
02어떤 순서로 동작하나
- 요청 수락
클라이언트 요청을 받고 호스트·경로 규칙과 접근 정책을 적용한다.
- 캐시 또는 전달 결정
정책에 맞는 유효 캐시가 있으면 사용하고 아니면 URI·헤더를 구성해 upstream에 연결한다.
- 뒤 서버 응답 수신
연결·전송·읽기 timeout과 버퍼 정책에 따라 응답을 받고 필요한 경우 저장한다.
- 클라이언트 반환
응답 상태·헤더·본문을 전달하고 클라이언트 구간과 upstream 구간의 시간·오류를 구분해 기록한다.
03먼저 알아둘 용어와 구성요소
- 의 location /api/에서 http://127.0.0.1:8000/처럼 URI /를 포함하면 정규화된 요청 URI 중 location에 대응하는 부분을 지정 URI로 대체하는 형태가 된다. /api/items는 백엔드의 /items가 될 수 있다.
- 프록시는 백엔드 연결을 유지해 다음 요청에 재사용할 수 있다. 이는 클라이언트 keep-alive와 별도 연결 풀이다.
- upstream에서 읽은 응답을 메모리와 설정상 임시 파일에 보관하며 클라이언트로 전달하는 저장 영역이다. 느린 클라이언트와 upstream 읽기 속도를 분리하는 대신 저장 자원을 사용한다.
- upstream과 새 연결을 수립하는 단계의 제한 시간이다. 연결이 만들어진 뒤 응답 데이터를 기다리는 과 적용 구간이 다르다.
- proxy_read_timeout은 일반적으로 upstream의 연속된 두 읽기 동작 사이의 제한 시간이다. 전체 응답이 반드시 그 시간 안에 끝나야 한다는 총 소요 시간 제한과 구분한다.
- 요청의 캐시 키와 재사용 조건에 맞는 저장 응답을 사용한 결과이다. 키에 빠진 사용자·헤더 차이를 무시하면 서로 다른 응답을 잘못 공유할 수 있다.
proxy_pass의 URI 유무로 백엔드 요청 경로 비교하기
upstream 선택과 URI 치환을 분리하여 같은 클라이언트 요청이 백엔드에 어떤 경로로 전달되는지 계산한다.
실습 구성과 전제
- 세 사진은 upstream 구성과 서로 다른 설정 예시다. 두 location 설정을 동시에 적용한 단일 서버 결과가 아니다.
- 일반적인 prefix location을 다룬다. location·변수 기반 ·rewrite가 섞인 경우는 별도 규칙을 확인해야 한다.
upstream은 목적 서버 집합을 정의한다
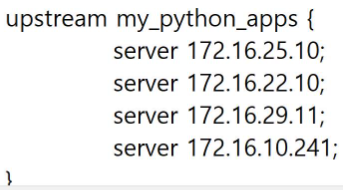
- 사진의 upstream에는 네 서버가 나열되고 에서 그 그룹 이름을 사용한다. 그룹 선택은 목적 백엔드에 관한 것이며 URI 경로 치환 자체와는 구별된다.
- 서버에 포트를 생략한 이 HTTP 설정은 기본 80을 사용한다. 각 서버가 실제 어떤 경로에 응답하는지는 애플리케이션 설정과 요청 로그로 확인해야 한다.
 원본 크기로 보기 ↗
- upstream my_python_apps 블록에 네 server 행이 나열된다.
- 각 server 행에는 주소가 있고 별도 포트가 표시되지 않는다.
확인 기준그룹에 등록되었다는 사실만으로 각 서버가 정상이라고 단정하지 않는다. 구성과 실제 연결·응답을 대조한다.
URI 없는 proxy_pass는 기존 경로를 전달한다
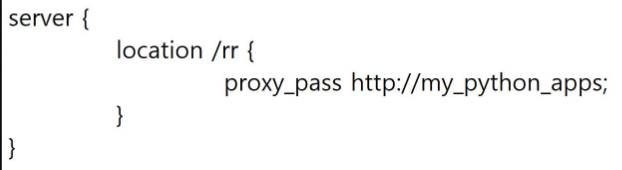
- 첫 location 예시는 /에 대해 http://my_python_apps;를 사용한다. URI를 붙이지 않은 이 단순 구성에서 //item?x=1 요청은 백엔드에도 //item?x=1로 전달된다.
- 일반 prefix /는 //뿐 아니라 /rrx 같은 문자열에도 맞을 수 있다. 경로 경계를 원한다면 trailing slash와 별도 exact location 설계를 고려한다.
 원본 크기로 보기 ↗
- location /rr 블록 안의 proxy_pass는 upstream 이름 뒤 곧바로 세미콜론으로 끝난다.
- upstream 주소 뒤에 /haha 같은 URI 부분이 없다는 것이 다음 사진과의 차이다.
확인 기준백엔드 404가 나오면 연결 실패로 단정하기 전에 백엔드가 받은 경로를 확인한다.
URI가 있으면 일치한 prefix를 치환한다
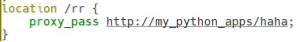
- 다음 사진의 는 /haha를 붙인다. 일반 prefix /에 //item?x=1이 들어오면 일치한 / 부분을 /haha로 바꾼 /haha/item?x=1이 전달되는 구성을 읽을 수 있다.
- 슬래시 한 개도 결과 경로에 영향을 준다. 재구성 예시처럼 location //와 /api/를 짝지으면 //item이 /api/item으로 매핑된다.
location /rr/ {
    proxy_pass http://lab_backend/api/;
}
재구성 예시: //item?x=1 → /api/item?x=1. lab_backend는 준비한 upstream 이름이다.
 원본 크기로 보기 ↗
- proxy_pass의 upstream 뒤에 /haha가 추가되어 있다.
- location은 앞 사진처럼 /rr이므로 목적 서버 집합보다 URI 치환 여부가 핵심 차이다.
확인 기준쿼리 문자열·정규화·rewrite 등 추가 설정이 없다면 계산한 경로를 백엔드 접근 로그에서 확인한다.
실습에서 확인한 동작 원리
- upstream은 서버 집합을, 의 URI 부분은 전달 경로의 치환을 결정한다.
- 프록시 앞의 URL과 백엔드 접근 로그를 연결하면 정상 연결 뒤 404가 발생하는 이유를 설명할 수 있다.
동작·명령 참고 문서
헬스 체크의 404와 사용자 503을 조건부로 연결하기
서버 등록· 검사·HTTP 상태 검사·사용자 응답을 구별하여 가용 서버가 사라지는 조건을 설명한다.
실습 구성과 전제
- 설정 화면, /healthz 패킷, 503 화면은 검사 조건을 달리한 실습 사례다. 첫 화면의 server check만으로 HTTP 404가 DOWN 판정의 원인이라고 단정하지 않는다.
- HTTP 상태를 기준으로 검사하려면 option httpchk 또는 http-check 설정이 실제 적용되어 있어야 한다. 아래 코드는 이를 명시한 재구성이다.
frontend의 분기와 backend의 서버 집합을 읽는다
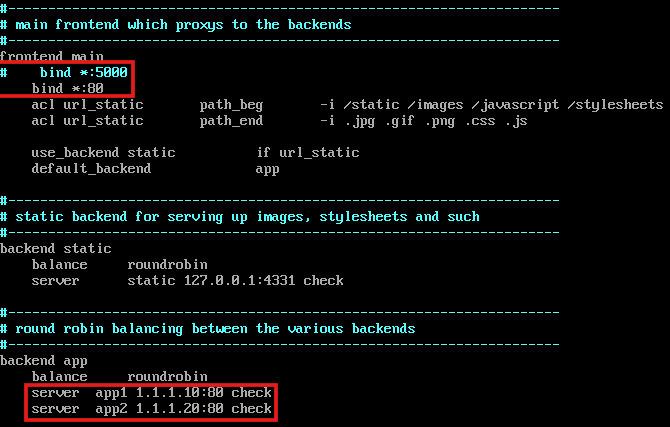
- frontend는 수신 포트와 을 정의하고 는 static, 나머지는 app으로 보낸다. app에는 roundrobin과 두 server 행이 보인다.
- server의 check는 능동 검사를 켜지만 검사 종류는 주변 설정에 달려 있다. HTTP 검사가 없으면 기본 연결 검사가 HTTP 본문의 상태까지 읽는 것으로 해석해서는 안 된다.
 원본 크기로 보기 ↗
- frontend는 80에서 받고 경로·확장자 ACL에 따라 backend를 나눈다.
- backend app은 balance roundrobin이며 두 server 행에 check가 붙어 있다.
확인 기준요청이 어느 backend로 갔는지와 그 backend의 검사 설정을 함께 확인한다. 다른 backend의 정상 상태를 근거로 삼지 않는다.
HTTP 검사 경로와 기대 상태를 명시한다
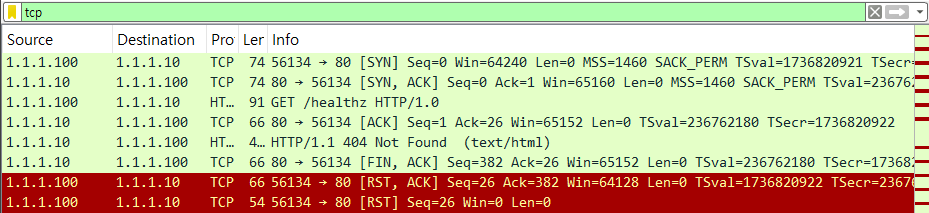
- 패킷 사진은 연결 수립 뒤 GET /healthz 요청에 404를 받은 사례다. 연결 자체는 가능하지만 그 URI는 기대한 상태를 반환하지 않는다.
- 재구성 설정에서 기대 상태를 200으로 정하면 404는 실패로 누적된다. fall 3이면 연속 세 번의 실패 후 DOWN, rise 2이면 연속 두 번의 성공 후 UP 조건이 된다.
backend lab_app
    mode http
    option httpchk GET /healthz
    http-check expect status 200
    server app1 192.0.2.21:80 check inter 2s fall 3 rise 2
    server app2 192.0.2.22:80 check inter 2s fall 3 rise 2
HTTP 200을 성공 기준으로 명시한 재구성이다. 사진의 초기 설정과 동일한 전체 설정이라고 가정하지 않는다.
 원본 크기로 보기 ↗
- TCP 연결 뒤 GET /healthz HTTP/1.0 요청이 보인다.
- 서버는 HTTP 404로 응답하므로 연결 성공과 준비 상태 URL의 성공이 구별된다.
확인 기준검사 URI가 실제 앱에 있는지, Host 헤더가 필요한지, 인증이 걸려 있지 않은지 확인한다. 404 자체가 곧 서버 종료를 뜻하지 않는다.
503을 서버 선택 상태와 맞춰 확인한다
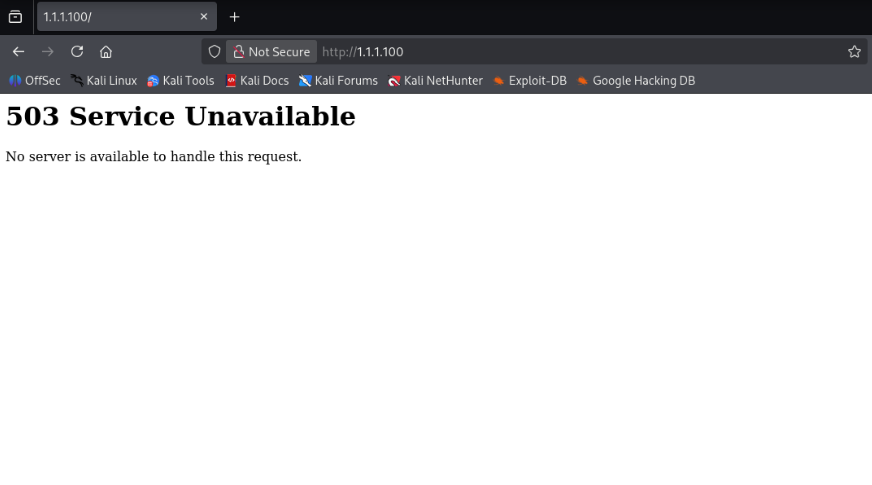
- 선택한 backend에 요청을 처리할 가용 서버가 없으면 프록시가 503을 반환할 수 있다. 사용자 화면의 503을 특정 한 패킷의 404와 연결하려면 같은 backend·시간·검사 상태라는 추가 증거가 필요하다.
- 정상 복구는 건강한 응답 한 번만 보는 것이 아니라 설정된 rise 조건을 통과해 선택 집합에 돌아오는 과정이다.
 원본 크기로 보기 ↗
- 브라우저 응답은 503 Service Unavailable이다.
- No server is available to handle this request라는 프록시 메시지가 보인다.
확인 기준상태·로그에서 선택 backend와 서버 UP/DOWN 사유를 대조한다. 앱이 직접 반환한 503과 프록시가 만든 503도 구별한다.
실습에서 확인한 동작 원리
- 연결 검사와 HTTP 준비 상태 검사는 성공 기준이 다르다.
- 검사 응답→연속 성공·실패 수→서버 선택 가능 여부→사용자 응답을 같은 조건과 시각으로 연결해야 한다.
동작·명령 참고 문서
04예제로 따라가기
- proxy_read_timeout이 5초여도 전체 응답 시간이 12초라는 이유만으로 실패하지 않는다. 연속 읽기 사이에 5초를 넘는 무응답 구간이 있는지가 핵심이다.
- 프록시 뒤 서버가 클라이언트 주소를 해석할 때는 신뢰한 프록시가 설정한 전달 헤더인지 확인해야 한다.
- 같은 URL이라도 인증·쿠키·Vary 같은 조건을 무시하고 캐시하면 사용자별 응답을 잘못 공유할 수 있다.
05혼동하기 쉬운 점과 확인 기준
- 캐시 HIT에서는 해당 요청에 대해 upstream을 새로 호출하지 않을 수 있다. 앱 로그가 없다는 사실을 곧바로 수집 장애로 판단하지 않는다.
- Host·URI·인증 상태·Vary 등의 차이를 캐시 키와 정책에 반영하지 않으면 서로 다른 사용자가 같은 객체로 취급될 수 있다. 사용자별 응답은 공유 캐시 적용 조건이 중요하다.
- 프록시가 만든 502/504와 앱이 반환한 같은 숫자의 응답은 발생 주체가 다를 수 있다. access/error 로그와 upstream 상태·주소·시간을 연결한다.
06상세 노트 · 실습 자료
헤더 구조, 설정 예시, 수치 계산과 수업 캡처는 아래 노트에서 이어집니다.
공식 문서 · 표준
기초 개념과 동작 설명을 대조한 자료입니다. 제품 버전과 실제 설정에 따른 차이는 본문 및 원문에서 확인하세요.