개발 · 자동화기초 · 19분 읽기
비트·진수·문자 인코딩과 Base64 계산
같은 바이트를 숫자·문자·전송 데이터로 해석하는 규칙을 익히고, 진수 변환과 UTF-8·Base64를 단계별로 계산합니다.
개념부터 찾아보기
정의·역할·동작 원리를 독립 페이지에서 확인하세요. 본문의 밑줄 용어에도 설명이 있습니다.
이 노트에서 설명할 수 있게 되는 것
- 진수 표기를 바꿔도 값은 같다는 점과 고정 폭 비트의 범위를 설명한다.
- 문자·코드 포인트·인코딩 바이트를 구분하고 한글의 바이트 수를 계산한다.
- Base64의 6비트 분할과 패딩을 손으로 계산하고 결과를 검증한다.
010과 1에 의미를 붙이는 규칙
- 비트와 바이트비트(bit)는 두 상태를 구분하는 단위이며, 일반적인 바이트(byte)는 8비트이다.
- 8개 비트를 조합하면 2⁸ = 256개의 서로 다른 패턴이 나온다.
- 부호 없는 정수로 해석하면 0~255이지만, 문자·색상·명령어·프로토콜 플래그 등 어떤 의미인지는 그 데이터를 사용하는 규칙이 결정한다.
- 같은 바이트, 다른 해석01000001은 부호 없는 정수로는 65이고, ASCII 문자로는 A이다.
- 65라는 숫자와 문자 A가 같은 개념인 것이 아니라, 문자표가 그 값과 글자를 대응시킨 것이다.
- 패킷 분석기의 왼쪽 16진 덤프와 오른쪽 문자 표시도 동일한 바이트의 서로 다른 표현이다.
- 출력되지 않는 바이트를 점으로 보여 주더라도 실제 값이 점 문자로 바뀐 것은 아니다.
02바이트를 의미로 해석하는 단계
- 입력 형태 확인화면의 41이 두 문자 “4”·“1”인지, 한 바이트 0x41의 16진 표시인지 구분한다.
- 필드 경계 확인프로토콜·파일 형식에서 필드의 시작 위치, 길이와 자료형을 찾는다.
- 정수 해석부호와 엔디언을 적용한다. 같은 FF도 부호 없는 8비트 값은 255, 2의 보수 값은 -1이다.
- 문자 해독문자 필드는 지정된 인코딩으로 decode한다. 문자 수와 바이트 길이를 별도로 계산한다.
- 추가 인코딩 해제·URL 인코딩이 명시되어 있으면 형식에 맞게 한 계층씩 해제한다. 성공한 해독은 내용의 안전성을 증명하지 않는다.
LEARN THROUGH PRACTICE
True·bool·0b1을 값·자료형·표현으로 나누기
같은 객체를 출력·형 조회·2진수 문자열 변환한 결과를 비교하고 표현 길이와 실제 메모리 크기를 구별한다.
실습 구성과 전제
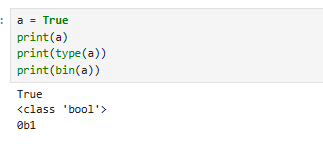
- 의 셀 실행 화면을 기준으로 한다. a에 True를 대입한 뒤 세 함수를 호출한다.
- 실제 수업 화면의 출력과 아래 추가 비교 예제를 구분한다. 2진 문자열의 자릿수로 객체의 저장 크기를 추정하지 않는다.
하나의 값에 서로 다른 질문을 한다
- print(a)는 값을 사람이 읽는 형태로 표시하고 type(a)는 객체의 자료형을 반환한다.
- bin(a)는 정수로 해석 가능한 값을 0b 접두사가 있는 문자열로 표현한다. 객체 자체를 1비트 저장소로 바꾸는 동작이 아니다.
 원본 크기로 보기 ↗
- a=True 뒤 출력 순서는 True, <class 'bool'>, 0b1이다.
- 입력 객체는 동일하지만 type과 bin의 반환 의미가 다르다.
확인 기준세 출력을 값·형·문자열 표현이라는 열로 나누어 적는다.
수치적 값과 정확한 자료형을 구분한다
- bool은 int의 하위 형식이어서 True는 정수 연산에서 1에 대응한다. 그렇다고 type(True)가 int로 바뀌지는 않는다.
- isinstance는 상속 관계까지 허용하는 검사이고 type(x) is T는 정확한 형을 비교한다. 용도에 따라 검사 결과가 다를 수 있다.
a = True
print(type(a).__name__)
print(int(a), bin(a), type(bin(a)).__name__)
print(isinstance(a, int), type(a) is int)
추가 비교 예제의 출력은 bool / 1 0b1 str / True False다.
확인 기준0b1은 bin의 반환 문자열이고 int(a)의 값 1과 형식이 다름을 설명한다.
정수 표현·바이트·문자 인코딩을 나누어 확인한다
- format(1, '08b')는 8자리 문자열을 만들고 int.to_bytes는 길이가 정해진 바이트열을 만든다. 같은 숫자의 서로 다른 직렬화 방식이다.
- 문자 '1'을 ASCII 또는 로 인코딩하면 값 0x31인 바이트가 된다. 정수 1을 한 바이트에 넣은 0x01과 같지 않다.
print(format(1, '08b'))
print((1).to_bytes(1, 'big').hex())
print('1'.encode('utf-8').hex())
각 출력은 00000001, 01, 31이다. 코드의 문자를 메모리 덤프 자체와 혼동하지 않는다.
확인 기준표현을 바꿀 때 입력의 형·출력의 형·길이를 각각 확인한다. 이 출력은 객체의 실제 메모리 점유를 보여 주지 않는다.
실습에서 확인한 동작 원리
- 자료형은 허용되는 연산을, 인코딩은 외부 바이트 표현을 정한다.
- 같은 1이라도 bool 값·정수·2진 문자열·문자 바이트는 다른 대상이다.
032진수·8진수·16진수: 자리의 가중치로 계산하기
- 자리 가중치진법은 수를 적는 방법이다.
- 2진수의 오른쪽부터 자리 가중치는 1, 2, 4, 8, 16, 32, 64, 128이다.
- 01000001₂는 64 + 1 = 65이고, 16진수 41₁₆도 4×16 + 1 = 65이다.
- 8진수 101₈은 1×64 + 0×8 + 1이다.
- 비트 묶음과 권한 표시16진수 한 자리는 정확히 4비트이므로 바이트 하나를 두 자리로 쓸 수 있다.
- 1110 1010₂는 E와 A를 붙인 EA₁₆이다.
- 8진수 한 자리는 3비트라 권한의 rwx 묶음과 연결하기 좋다.
- rw-는 110₂ = 6, r--는 100₂ = 4이므로 rw-r--r--는 644이다.
- 진수 자체가 권한을 만드는 것이 아니라 이미 정한 비트의 조합을 간결하게 표시한다.
| 표현 | 값 또는 의미 | 읽을 때 주의할 점 |
|---|---|---|
| 0b01000001 | 십진수 65 | 0b는 등의 2진 리터럴 접두사 |
| 0o101 | 십진수 65 | 숫자 101의 십진 표기와 다르다 |
| 0x41 | 십진수 65 | 0x는 16진수 표기 |
| '65' | 문자 6과 문자 5 | ASCII/ 바이트로는 36 35, 정수 65의 한 바이트 41과 다르다 |
print(int('01000001', 2))  # 65
print(bin(65), oct(65), hex(65))  # 0b1000001 0o101 0x41
print(format(65, '08b'))  # 01000001
계산 예제. bin()이 생략한 앞쪽 0은 값에 영향을 주지 않지만, 프레임 필드의 폭을 설명할 때는 8자리로 맞춰 읽는다.
04비트 폭·부호·바이트 순서는 서로 다른 문제
- 폭과 부호8비트 부호 없는 값은 255 다음 값을 같은 폭에 담을 수 없다.
- 2의 보수 부호 있는 8비트 정수는 -128~127을 표현하며 FF는 그 규칙에서 -1이다.
- 따라서 바이트 FF만 보고 255인지 -1인지 단정할 수 없다.
- 필드 정의의 자료형과 길이를 함께 읽어야 한다.
- int는 고정 32비트 정수와 달리 사용 가능한 메모리 안에서 큰 정수를 표현하므로 언어마다 같은 overflow를 기대해서도 안 된다.
- 엔디언2바이트 정수 0x1234를 메모리나 파일에 놓을 때 big-endian은 12 34, little-endian은 34 12 순서로 둔다.
- 이는 여러 바이트의 순서이며, 0x1234라는 수를 16진법으로 적는 방식과 구분한다.
- 네트워크 헤더를 직접 파싱할 때 프로토콜이 정한 순서를 지정해야 한다.
- 아래 예제는 잘못된 순서가 어떻게 다른 숫자를 만드는지 보여 주는 보충 계산이다.
raw = bytes.fromhex('12 34')
print(int.from_bytes(raw, 'big'))     # 4660
print(int.from_bytes(raw, 'little'))  # 13330
print((4660).to_bytes(2, 'big').hex(' '))  # 12 34
수업의 진수 개념을 바이너리 해석에 연결한 재현 예제다. 실제 수업 캡처가 아니다.
원리 심화
05필드의 폭·정렬·부호와 Unicode 정규화
- 정수의 표현 범위n비트 unsigned는 0부터 2ⁿ−1, 2의 보수 signed는 −2ⁿ⁻¹부터 2ⁿ⁻¹−1까지 표현한다. 8비트 FF는 전자에서 255, 후자에서 −1이다.
- 필드 폭과 연산 폭저장 형식의 범위와 언어의 정수 연산 규칙을 구분한다. int로 256을 계산할 수 있어도 unsigned 1바이트 필드에 그대로 pack할 수는 없다.
- 정렬과 paddingC 구조체의 메모리 배치에는 정렬용 빈 바이트가 들어갈 수 있다. 프로토콜은 필드별 폭·순서·padding을 따로 정의해야 가 달라도 같은 데이터를 읽는다.
- struct 접두어 struct의 !는 표준 크기의 big-endian 형식이고 자동 정렬 padding을 넣지 않는다. @는 실행 환경의 크기·정렬 규칙을 따른다.
- 와 화면의 글자é는 U+00E9 하나 또는 e와 U+0301의 조합으로 표현될 수 있다. 같은 모양이어도 수· 바이트열·해시가 다를 수 있다.
- 의 계약검색·식별자의 비교 규칙에 맞춰 NFC 등의 를 정한다. 원본 바이트를 검증하는 서명·해시는 전후 어느 데이터를 대상으로 하는지 명시한다.
06ASCII·Unicode·UTF-8을 분리해서 이해하기
- 문자 번호와 저장 형식ASCII는 영문자·숫자·제어문자 등에 0~127의 값을 배정한 문자 코드이다.
- 는 더 넓은 문자 집합에 를 부여한다.
- 예를 들어 A는 U+0041, 가는 U+AC00이다.
- 은 의 유효한 스칼라 값을 1~4바이트로 옮기는 인코딩 규칙이다.
- 을 동의어로 쓰면 “문자의 번호”와 “저장한 바이트”를 혼동하게 된다.
- ord와 chr의 chr()/ord()는 와 문자를 변환한다.
- ord("가")는 44032이고 chr(44032)는 "가"이다.
- 이 정수 44032를 십진 문자열로 전송한 결과와, 글자 가를 로 인코딩한 결과는 서로 다르다.
- 바이트 계산에서 U+AC00의 비트 1010 1100 0000 0000을 3바이트 틀 1110xxxx 10xxxxxx 10xxxxxx에 채우면 11101010 10110000 10000000, 즉 EA B0 80이 된다.
- ASCII 범위의 A는 41 한 바이트다.
- 문자열 길이 1과 전송 길이 3을 구분해야 파일 위치·요청 길이·버퍼 크기를 올바르게 계산한다.
text = '가'
raw = text.encode('utf-8')
print(ord(text), hex(ord(text)))  # 44032 0xac00
print(len(text), len(raw))       # 1 3
print(raw.hex(' '))              # ea b0 80
print(raw.decode('utf-8'))       # 가
str 길이는 수를 센다. 결합 문자나 여러 로 된 이모지에서는 눈에 보이는 글자 수와도 다를 수 있다.
07인코딩 오류는 어느 경계에서 생기는가
- encode와 decode프로그램 내부의 str을 파일·소켓으로 내보낼 때 encode, 바이트를 읽어 str로 해석할 때 decode가 필요하다.
- 송신자가 로 기록한 바이트를 수신자가 다른 문자표로 해석하면 글자가 깨지거나 오류가 난다.
- bytes를 str(raw)로 바꾸면 원문 해독 대신 b'...' 형태의 표현 문자열을 얻으므로 decode와 같지 않다.
- 스트림의 문자 경계 한글 바이트를 중간에서 잘라 각 조각을 따로 해독하면 UnicodeDecodeError가 날 수 있다.
- 스트림에서 read 한 번이 완전한 문자나 한 줄을 보장하지 않기 때문이다.
- 텍스트 스트림 또는 상태를 유지하는 디코더를 사용하고, 프로토콜의 길이 기준이 문자 수인지 바이트 수인지 확인한다.
- 오류와 원본 보존errors="ignore"로 오류를 숨기면 바이트가 사라진 사실을 모른 채 로그를 분석할 수 있다.
- 조사용 원본 바이트는 보관하고, 화면 표시용 대체 문자와 원본을 구분한다.
- HTTP·HTML·메일의 문자셋 표기와 실제 바이트도 일치해야 한다.
08Base64: BYE의 바이트와 6비트 묶음 계산
- 3바이트를 4문자로의 입력은 임의의 바이트열이다.
- 입력이 글자라면 먼저 등으로 인코딩한다.
- 연속된 3바이트 = 24비트를 왼쪽부터 6비트씩 네 묶음으로 나누고, 각 묶음의 0~63 값을 정해진 문자표에 대응시킨다.
- 키나 비밀 규칙을 쓰지 않으므로 누구나 역변환할 수 있다.
- BYE 계산 예BYE의 ASCII/ 바이트는 42 59 45이다.
- 이진수 01000010 01011001 01000101을 다시 나누면 010000 / 100101 / 100101 / 000101이다.
- 십진수로 16 / 37 / 37 / 5이며, 문자표에서 Q / l / l / F가 된다.
- 올바른 결과는 QllF이다.
- 소문자 l을 대문자 L로 옮긴 QLLF는 다른 바이트로 해독된다.
| 6비트 | 십진 인덱스 | 문자표 결과 |
|---|---|---|
| 010000 | 16 | Q |
| 100101 | 37 | l (소문자 엘) |
| 100101 | 37 | l (소문자 엘) |
| 000101 | 5 | F |
import base64
encoded = base64.b64encode(b'BYE')
print(encoded.decode('ascii'))        # QllF
print(base64.b64decode(encoded))      # b'BYE'
print(base64.b64decode(b'QLLF').hex()) # 40b2c5
원본 필기의 계산 대상을 그대로 사용하고 대소문자 오류를 바로잡은 검산 예제다.
09남은 1·2바이트와 = 패딩
- 마지막 묶음의 패딩입력이 3의 배수 바이트이면 네 글자 묶음을 완전히 채운다.
- 마지막에 1바이트만 남으면 유효한 8비트를 6+2비트로 나누고 마지막 2비트 뒤에 0을 네 개 채워 두 문자를 만든 뒤 ==를 붙인다.
- 2바이트가 남으면 6+6+4비트에서 마지막에 0 두 개를 채워 세 문자를 만들고 = 하나를 붙인다.
- =는 데이터 비트의 암호화 결과나 공백 문자가 아니라, 마지막 묶음의 길이를 표현하는 표식이다.
- 출력 길이와 변형일반적인 패딩 포함 의 길이는 4×ceil(입력 바이트 수/3)이다.
- 큰 데이터에서는 대략 4/3배이며 압축 방식이 아니다.
- URL용 Base64url은 +와 / 자리에 -와 _를 쓰며, 패딩 생략 여부는 사용하는 상위 형식의 규칙을 따라야 한다.
- “어떤 인지”까지 정해야 상호 운용된다.
| 입력 | 입력 바이트 수 | 패딩 포함 결과 |
|---|---|---|
| B | 1 | Qg== |
| BY | 2 | Qlk= |
| BYE | 3 | QllF |
| 가 () | 3 | 6rCA |
import base64
for text in ['B', 'BY', 'BYE', '가']:
    raw = text.encode('utf-8')
    print(text, len(raw), base64.b64encode(raw).decode('ascii'))
모든 입력은 바이트로 바꾼 다음 같은 과정을 거친다.
예제로 추적
107바이트 가상 메시지를 헤더부터 복원하기
- 형식 선언학습용 형식은 version 1바이트, flags 1바이트, payload 길이 2바이트 big-endian, payload로 정한다. 실제 표준 프로토콜의 헤더는 아니다.
- 헤더 분리01 05 00 03 ED 95 9C에서 처음 4바이트는 헤더다. version=1, flags=5, 길이=3으로 읽는다.
- 비트 마스크 적용flags & 0x01과 flags & 0x04가 0이 아니므로 두 기능 비트가 켜져 있다. 예약 비트 0xF8은 0인지 확인한다. 각 비트의 의미는 이 형식의 별도 계약이다.
- 길이 검증전체 7바이트에서 헤더 4바이트를 빼면 payload 3바이트다. 00 03을 little-endian으로 읽은 768은 계약과 맞지 않으며 데이터가 부족한 상태가 된다.
- 문자 복원ED 95 9C를 로 해독하면 한이다. 길이 필드는 문자 개수 1이 아니라 바이트 개수 3을 나타낸다.
- 역변환 검증같은 규칙으로 다시 pack·encode한 바이트가 입력과 일치하는지 비교한다. 출력 문자열이 그럴듯하다는 사실만으로 해독이 맞았다고 판단하지 않는다.
import struct
raw = bytes.fromhex('01 05 00 03 ED 95 9C')
version, flags, size = struct.unpack('!BBH', raw[:4])
assert version == 1 and flags & 0xF8 == 0
assert len(raw) == 4 + size
text = raw[4:].decode('utf-8', errors='strict')
# 계산 결과: (version, flags, size, text) == (1, 5, 3, '한')
가상 메시지의 필드 해석 예제. 실제 통신 데이터를 캡처한 결과가 아닙니다.
11패킷·로그·파일 분석에 적용하는 순서
- 필드 해석 기준처음에는 원본 바이트와 표시 형식을 분리한다.
- 41이 보인다면 두 ASCII 글자 "4", "1"인지, 분석기가 한 바이트 0x41을 표시한 것인지부터 확인한다.
- 다음으로 필드 길이·부호·엔디언을 확인하고, 텍스트 필드이면 문자 인코딩을 적용한다.
- 나 URL 인코딩이 추가되었으면 명시된 규칙대로 한 계층씩 해제한다.
- 의 구분해독에 성공했다는 사실만으로 내용이 안전하거나 신뢰할 수 있다는 뜻은 아니다.
- HTTP Basic 인증의 자격 증명도 일 뿐이며 기밀성은 같은 별도 보호에 의존한다.
- 로그에서 처럼 보이는 문자열을 찾았다고 곧바로 악성 행위라고 판단하지 않고, 정상 토큰·메일 첨부·인증 데이터인지 사용 맥락과 함께 읽는다.
검증·예외
12문자 깨짐·길이 불일치·중복 디코딩의 진단 순서
- 원본 확보해석 전 바이트 길이와 16진수를 남긴다. 로그 화면에 표시된 문자열을 다시 저장하면 이미 잘못 해독된 결과만 남을 수 있다.
- 전송 경계 분리한 번의 read 결과가 문자·메시지 하나와 같지는 않다. 문자의 일부가 다음 조각에 올 수 있어 스트림 해독기는 미완성 바이트를 유지해야 한다.
- 단계마다 길이 기록수신 바이트 → 해제 바이트 → 문자 해독 결과의 길이를 따로 확인한다. 출력 길이는 압축률이나 원본 문자 수가 아니다.
- 잘못된 오류 은폐errors=ignore는 문제 바이트를 없애고 replace는 대체 문자를 넣는다. 복구가 목적일 수는 있지만 원본 보존·동일성 검증과 같은 작업은 아니다.
- 해독 횟수 일치프록시·웹 서버·애플리케이션이 서로 다른 횟수로 URL 해독을 하면 검사한 값과 사용하는 값이 달라질 수 있다. 각 경계의 실제 표현을 비교한다.
- 크기와 자원 제한길이 필드를 신뢰해 즉시 큰 버퍼를 할당하지 않는다. 허용 최대값·남은 바이트·중첩 단계 수를 확인하고 불완전한 메시지는 명확하게 거절한다.
학습 확인
이해했는지 확인하기
- 0x41 한 바이트와 문자열 "41"의 두 바이트를 구별할 수 있는가?
- 가의 코드 포인트, UTF-8 바이트, Base64 결과를 각각 계산할 수 있는가?
- BYE의 결과에서 소문자 l을 대문자 L로 바꾸면 왜 원문이 달라지는가?
- Base64 길이 증가와 패딩 수를 입력 바이트 수로 설명할 수 있는가?