정보보안기초 · 15분 읽기
인코딩·해시·암호화 구분하기
문자열이 읽기 어려워졌다는 이유만으로 보호되는 것은 아니다. 복원 가능성, 키 사용 여부, 검증 목적을 기준으로 세 기술을 구분한다.
개념부터 찾아보기
정의·역할·동작 원리를 독립 페이지에서 확인하세요. 본문의 밑줄 용어에도 설명이 있습니다.
이 노트에서 설명할 수 있게 되는 것
- 같은 바이트의 인코딩·해시·암호화 결과가 갖는 의미를 구분한다.
- 신뢰된 기준 해시로 파일 검증이 가능한 조건을 설명한다.
- Salt와 비밀번호 해시 비용의 역할을 구분한다.
먼저 알면 좋은 개념보안의 기준: CIA·AAA와 위험 판단
01개념과 구성 요소
- 인코딩같은 바이트를 다른 표현으로 바꾼다. 디코딩에는 비밀키가 필요하지 않다.
- 해시메시지를 정해진 형식의 로 요약하며, 복호화를 목적으로 하지 않는다.
- 키가 필요한 검증은 공유 비밀키, 은 개인키·공개키를 사용해 메시지와 키의 관계를 검증한다.
02비밀번호 등록과 로그인 검증의 순서
- 등록 입력 받기서버가 비밀번호를 받아 비밀번호 저장 전용 함수의 입력으로 사용한다.
- 와 비용 설정사용자별 와 계산 비용을 정해 같은 비밀번호의 저장값이 단순히 같아지지 않도록 한다.
- 검증 자료 저장알고리즘·비용··결과 등 나중에 검증할 자료를 저장하며 평문 비밀번호를 보관하지 않는다.
- 로그인 입력 검증저장 형식을 읽고 같은 조건의 검증 함수로 입력 비밀번호가 일치하는지 판단한다.
- 조건 갱신검증이 성공했고 기존 비용이나 형식을 갱신해야 한다면 새 조건으로 저장값을 다시 만든다.
03같은 문자열처럼 보여도 바이트 표현은 다르다
- 입력 바이트컴퓨터가 해시하거나 암호화하는 대상은 화면의 글자 모양이 아니라 바이트 열이다. 문자열 A는 에서 0x41이고, 이 바이트를 로 표현하면 QQ==다.
- 표현다시 를 풀면 0x41을 얻는다. 문자열을 바이트로 바꾸어 해시한 결과와 디코딩한 원래 바이트를 해시한 결과는 서로 다르다.
- 인코딩과 비밀인코딩은 비밀키 없이 정해진 규칙으로 되돌릴 수 있는 표현 변환이다.
- 퍼센트 인코딩URL의 퍼센트 인코딩은 전달 문맥에서 특별한 의미를 가진 바이트를 표현한다. HTML 엔티티는 HTML 파서가 문자를 해석하는 방법에 관여한다.
- 디코딩 경계둘을 일반적인 암호화라고 부르면 나 URL 파싱 문제를 잘못 이해하게 된다. 어떤 디코더가 어느 단계에서 적용되는지에 따라 같은 입력이 나중에 제어 문자나 구문으로 바뀔 수 있다.
text
원래 바이트: 41 (16진수)
UTF-8 문자: A
Base64 표현: QQ==
Base64 디코딩 결과: 41

H(바이트 41) ≠ H(문자열 "QQ=="의 UTF-8 바이트)
표현과 원래 바이트를 구분하는 작은 예시다. 두 해시는 서로 다른 입력에 대한 계산이다.
04해시·암호화·MAC·서명의 출력이 뜻하는 것
- 해시와 암호화는 입력으로부터 요약값을 계산하며 정상적인 복호화 키를 제공하지 않는다. 암호화는 비밀키 또는 키 쌍과 알고리즘을 이용해 평문을 암호문으로 만들고, 허용된 복호화 절차로 복원한다.
- ·서명은 비밀키를 함께 사용해 메시지가 그 키를 아는 주체에 의해 인증되었는지 검증한다. 서명은 개인키로 만들고 공개키로 검증한다.
- 해시 출처의 신뢰파일과 그 파일의 을 같은 공격자가 동시에 바꿀 수 있다면 해시 비교만으로 배포자를 인증하지 못한다. 검증자는 신뢰한 별도 경로의 기준 해시, 또는 서명이 필요하다.
- 재생 방지또한 재생 방지는 무결성과 별개의 문맥이다. 예전에 정상적으로 인증된 메시지를 그대로 다시 보내면 태그는 여전히 유효할 수 있으므로 프로토콜에 순서 번호·Nonce·만료 시각 같은 신선도 조건을 결합한다.
| 기술 | 핵심 입력 | 주된 결과 |
|---|---|---|
| 인코딩 | 바이트와 표현 규칙 | 내용을 다른 형식으로 표현 |
| 해시 | 메시지 | 입력의 |
| 암호화 | 메시지·키·모드 매개변수 | 기밀성 보호 |
| 메시지·공유 비밀키 | 무결성과 키 보유 근거 | |
| 메시지·개인키 | 공개키로 검증하는 서명 |
05역상·제2역상·충돌 저항성의 차이
- 역상·제2역상은 주어진 출력 h에 대해 H(m)=h인 입력 m을 찾기 어려워야 한다는 요구다. 은 이미 정해진 메시지 m에 대해 같은 해시를 만드는 다른 메시지 m′을 찾기 어렵다는 요구다.
- 에서는 공격자가 두 메시지를 모두 고를 수 있지만 서로 다른 m과 m′의 해시가 같아야 한다. 출발 조건이 다르므로 세 문제를 하나로 설명하지 않는다.
- 입력 공간입력 공간은 출력 공간보다 크므로 충돌 자체는 존재한다. 안전성의 뜻은 충돌이 수학적으로 없다는 것이 아니라 현실적인 비용으로 원하는 충돌을 찾기 어렵다는 것이다.
- 생일 경계이상적인 n비트 해시의 일반적인 충돌 탐색은 생일 현상 때문에 대략 2^(n/2) 규모에서 문제가 되고, 단일 목표 역상 탐색의 일반적인 규모와 다르다. 이는 이상적인 함수에 대한 이해 모델이며 특정 알고리즘의 실제 공격 비용을 자동으로 보장하지 않는다.
06반복 압축과 스펀지 구조
- 반복 압축Merkle–Damgård 계열의 반복 압축과 의 스펀지는 메시지를 해시로 바꾸는 서로 다른 구조다. 반복 압축 구조는 메시지를 으로 나누고 ·길이 정보를 포함한 뒤 이전 연결값과 새 을 압축 함수에 넣는다.
- 와 출력 비트 수와 내부 크기는 같은 개념이 아니다. 예를 들어 의 가 256비트라는 말은 메시지를 256비트씩 처리한다는 뜻이 아니다.
- 스펀지는 Keccak의 스펀지 구조를 사용한다. 입력을 내부 상태에 흡수하고 순열을 반복한 뒤 출력을 짜내는 방식으로 이해할 수 있다.
- SHAKE·역사적 계열일반 해시와 가변 길이 출력을 제공하는 SHAKE도 구분한다. MD5·SHA-1·RIPEMD·Tiger·HAVAL·HAS-160은 서로 다른 역사와 설계를 가진 해시 계열이다.
- 용도별 선택새 시스템의 선택은 이름 목록이 아니라 용도와 해당 알고리즘의 안전성에 따라 결정한다.
원리 심화
07SHA-256의 블록·패딩·길이 필드
- 과 상태은 512비트 입력 과 여덟 개의 32비트 상태 word를 사용해 256비트 결과를 만든다.
- 조건원래 비트 길이를 L이라 하면 1비트와 k개의 0을 붙여 L+1+k≡448 mod 512가 되게 한다.
- 원래 길이마지막 64비트에는 전 메시지 길이 L을 넣는다. 패딩된 총 길이나 문자 개수를 넣는 값이 아니다.
- 표현의 차이문자열은 먼저 정해진 인코딩의 바이트가 된다. 같은 화면 글자도 정규화·인코딩·줄바꿈이 다르면 다른 입력이다.
- 출력 형식256비트 결과는 32바이트이고 16진수로 쓰면 64문자다. 64문자를 다시 해시하면 원래 32바이트를 해시한 것과 다르다.
예제로 추적
0855바이트와 56바이트 입력의 패딩 계산
- 55바이트 입력가상 메시지의 길이는 55×8=440비트다. 1비트 뒤 0을 7개 넣으면 448비트가 된다.
- 길이 붙이기64비트 길이 필드를 붙이면 총 512비트, 즉 한 이 된다.
- 56바이트 입력448비트 입력에 1비트를 붙이면 마지막 길이 필드를 같은 에 넣을 수 없다.
- 두 완성0을 511개 붙여 960비트로 만든 뒤 64비트 길이를 넣으면 1024비트, 두 이다.
- 해석입력이 한 바이트 늘어도 내부 처리 이 늘 수 있다. 두 경우 모두 최종 해시 출력은 32바이트다.
검증·예외
09해시가 예상과 다를 때 비교할 바이트
- 줄바꿈LF 한 바이트와 CRLF 두 바이트, 마지막 개행 유무를 구분한다. 화면의 문장만 비교하면 차이를 놓친다.
- 텍스트 변환 BOM·문자 정규화·공백 제거가 어느 단계에 적용되었는지 확인하고 변환 전후 길이를 기록한다.
- 표현 혼동16진수 문자열· 문자열·디코딩된 원시 바이트 중 실제 함수에 들어간 자료형을 확인한다.
- 기준값의 신뢰해시가 일치해도 비교 기준이 같은 공격자에게 바뀌었다면 출처는 증명되지 않는다. 서명된 배포 정보 등 별도 신뢰 경로가 필요하다.
10길이 확장 문제와 HMAC이 필요한 이유
- 길이 확장일부 반복 해시에서는 메시지의 해시와 원래 길이를 알면 원문을 몰라도 특정 뒤에 데이터를 덧붙인 형태의 해시를 계산할 수 있다. 따라서 H(secret || message)를 임의의 인증 방식으로 만드는 것은 안전한 설계와 같지 않다.
- 적용 범위이 현상은 모든 해시와 모든 사용 방식에 똑같이 적용되는 만능 복호화 기법이 아니다.
- 구조은 키를 크기에 맞춰 처리하고 내부 패드와 외부 패드를 사용하는 중첩 구조다. 같은 키와 같은 메시지라면 같은 태그가 나오고, 수신자는 재계산한 태그와 비교한다.
- 태그의 신뢰평문과 태그는 공개되어도 되지만 비밀키는 공유 참여자에게만 있어야 한다. 두 참여자가 같은 키를 알고 있으므로 검증은 공개 검증 가능한 과 책임 귀속 범위가 다르다.
text
HMAC(K, m) = H((K′ XOR opad) || H((K′ XOR ipad) || m))
K′: 해시의 블록 크기에 맞춰 처리한 키
||: 바이트 연결
ipad / opad: 서로 다른 고정 패드의 구조를 읽기 위한 식이다. 키 처리와 비교는 검증된 라이브러리가 담당해야 한다.
11비밀번호 저장은 빠른 파일 해시와 목적이 다르다
- 비밀번호 저장 목적파일 무결성 검사는 큰 파일을 빠르게 해시하는 성질이 유리하지만 비밀번호 후보 검증은 공격자가 대량 반복할 수 있다. 비밀번호 저장 함수는 와 계산 비용을 사용하여 후보 하나를 확인하는 비용을 조절한다.
- 는 사용자별로 달라야 하며 비밀일 필요는 없다. 같은 비밀번호를 가진 두 사용자가 같은 저장값을 갖지 않게 하고 미리 계산한 표를 재사용하는 효과를 줄인다.
- CostCost는 반복 횟수나 메모리·병렬성 같은 매개변수다. , scrypt, bcrypt, PBKDF2는 동일한 필드와 단위를 사용하는 이름이 아니므로 라이브러리 형식을 그대로 읽어야 한다.
- 저장 형식레코드에는 알고리즘·버전·비용··결과가 함께 저장될 수 있다. 로그인 때는 입력 비밀번호를 저장된 매개변수로 검증하며, 성공 후 정책이 바뀌었다면 새 형식으로 다시 저장하는 migration이 가능하다.
12Hash-Identifier 결과는 후보 목록이다
- 형식 기반 후보Hash-Identifier는 길이, 사용 문자, 접두사, 구분자를 보고 가능한 알고리즘을 제시한다. 32자리 16진수라는 이유만으로 MD5를 확정할 수 없다.
- 외형의 중복다른 알고리즘의 잘린 출력이나 사용자 정의 형식도 같은 외형을 가질 수 있다. $2b$ 같은 bcrypt 형식 표지와 $$ 표지는 더 강한 단서지만 전체 필드와 해당 애플리케이션의 저장 방식을 함께 해석한다.
- 식별과 검증이 작업은 암호문 복호화나 비밀번호의 평문 획득이 아니다. DB 컬럼의 길이, 프레임워크의 비밀번호 함수, 같은 시스템의 정상 표본과 생성 설정이 알고리즘 판정의 근거가 된다.
- 저장 구현 대조해시 표본의 형식을 분석하는 것과 유출된 자격 정보로 계정에 접근하는 것은 별개의 활동이며 여기서는 전자의 구조만 다룬다.
13파일 해시 실습에서 실제로 달라지는 값
- 바이트 변화파일에 줄바꿈 하나를 추가하면 바이트가 바뀌므로 해시도 바뀐다. 반면 같은 해시를 대문자 16진수와 소문자 16진수로 표기하는 것은 같은 의 표현 차이다.
- 동일 파일 비교복사 전후 무결성을 비교하려면 같은 알고리즘으로 같은 바이트 범위를 계산해야 한다. 압축된 파일과 압축 해제한 파일의 해시는 대상이 달라서 직접 비교할 수 없다.
- 기준값의 출처다운로드 파일을 계산한 뒤 신뢰한 배포 메타데이터의 값과 비교하면 전송·저장 중 바이트 변경을 판별하는 데 도움이 된다. 일치하지 않을 때 원인은 손상, 다른 버전, 잘못된 파일 선택, 변조 등일 수 있어 해시 불일치 하나만으로 악성 여부를 확정하지 않는다.
- 해시와 서명이 원리는 포렌식 증거 사본과 PCAP 표본을 식별할 때도 그대로 이어진다.
설명과 함께 보는 보조 도식
처리 과정
모식도 · 파일 해시의 신뢰된 비교
파일과 기준값의 출처를 별도로 생각한다.
01수신 파일검증할 실제 바이트
02해시 계산SHA-256 등 선택한 함수
03신뢰한 기준값별도 검증된 배포 정보
04비교 결과동일 바이트 여부에 대한 근거
01
계산
받은 파일 전체에서 요약값을 만든다.
전체 단계를 한 번에 읽기
- 01
계산
받은 파일 전체에서 요약값을 만든다.
- 02
기준 확보
기준 해시의 배포 경로 또는 서명을 확인한다.
- 신뢰 대상
- 기준값의 출처
- 03
대조
알고리즘과 대상 버전이 같은 값끼리 비교한다.
- 불일치
- 변조·전송·버전 차이를 추가 확인
LEARN THROUGH PRACTICE
설치 이미지 해시 비교와 비밀번호 해시를 구분하기
파일 무결성 비교에서 문자열 처리 오류를 분리하고, 같은 해시 도구를 비밀번호 저장에 그대로 쓰면 안 되는 이유를 설명한다.
실습 구성과 전제
- 검증할 설치 이미지의 작업 사본과 배포자가 신뢰 가능한 경로로 제공한 값을 준비한다.
- 사진의 파일 경로·해시를 복사하지 말고 자신의 파일과 공식 배포 값으로 비교한다.
파일 바이트의 SHA-256을 계산한다
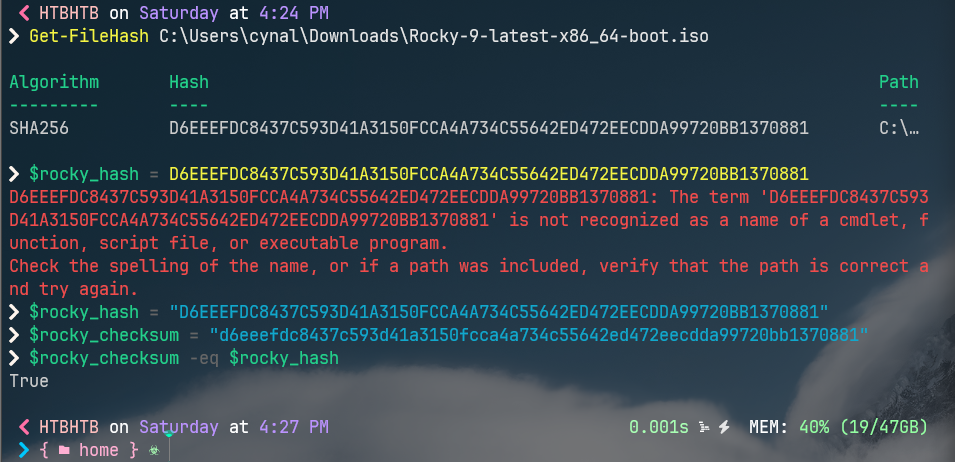
- Get-FileHash는 경로 문자열이 아니라 파일 내용을 읽어 를 만든다. 다운로드 파일이 다르거나 일부 바이트가 변경되면 비교가 실패한다.
- 알고리즘과 배포 파일 종류를 먼저 맞춘다. 같은 제품의 boot ISO와 DVD ISO는 다른 파일이다.
powershell$actual = (Get-FileHash -Algorithm SHA256 -LiteralPath .\lab.iso).Hash $expected = '배포자가 제공한 SHA-256 문자열' $actual -eq $expected파일을 변경하지 않는 조회 예시. expected에는 신뢰 가능한 공식 값을 넣는다.
 원본 크기로 보기 ↗
- Algorithm 열이 SHA256이며 Get-FileHash 결과와 비교식의 True가 함께 보인다.
- 따옴표 없이 해시를 대입한 줄에는 명령으로 인식할 수 없다는 오류가 있다. 이는 해시 불일치가 아니라 PowerShell 구문 처리 문제다.
확인 기준비교 전에 계산 오류·다른 파일·다른 알고리즘을 각각 배제한다.
비교 결과가 증명하는 범위를 제한한다
- True는 선택한 두 문자열이 같다는 뜻이다. 기대 해시를 파일과 같은 위조 경로에서 받았다면 공급자 진정성까지 증명되지 않는다.
- 대소문자가 다른 16진수 표기는 같은 를 표현할 수 있다. 공백·개행·알고리즘 표시를 제거할 때도 원래 64자리 값을 손상시키지 않는다.
확인 기준일치·불일치와 별도로 기대 값의 출처를 기록한다.
파일 해시와 비밀번호 저장 목적을 비교한다
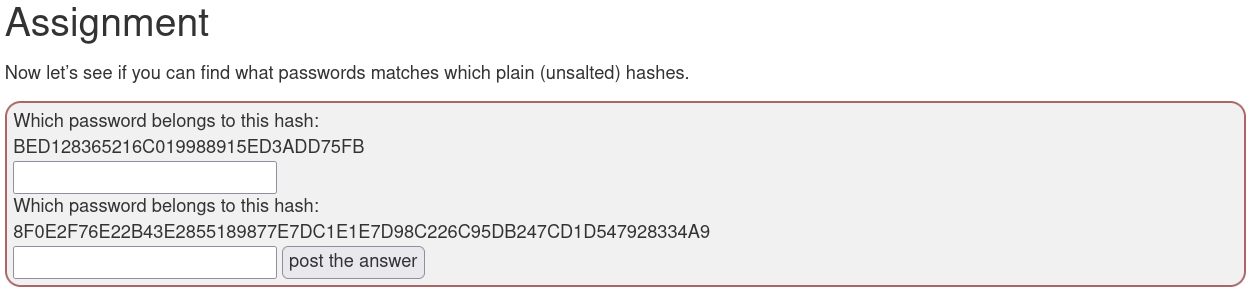
- 과제의 unsalted hash는 후보 문자열을 같은 함수에 넣어 결과가 같은지 비교하는 대상이다. 출력 길이는 알고리즘 후보의 단서일 뿐 확정 근거가 아니다.
- 실제 비밀번호 저장에는 고유 와 비용을 조절하는 전용 함수가 필요하다. 빠른 파일 검사는 이 목적을 대신하지 않는다.
 원본 크기로 보기 ↗
- 과제는 plain (unsalted) hashes라고 명시하며 서로 길이가 다른 두 출력을 제시한다.
- 화면에는 해시에서 원문을 복호화하는 키가 없다. 가능한 입력을 해시해 비교하는 문제다.
확인 기준해시·인코딩·암호화를 각각 비교·표현·기밀성 기능으로 구분한다.
실습에서 확인한 동작 원리
- 파일 무결성은 계산값과 신뢰 가능한 기대값의 비교다.
- 빠른 파일 해시와 느리게 설계하는 은 목적이 다르다.
설정·출력 추가로 확인하기 1장
아래 화면을 펼쳐 위 실습의 설정값, 명령과 확인 기준을 비교해 보세요. 각 묶음은 별도 실습 기록입니다.
실습 화면 묶음 01 1장
 원본 크기로 보기 ↗
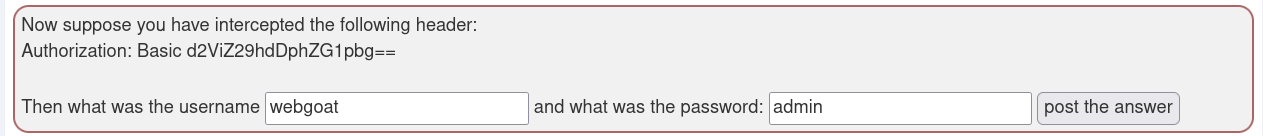
- 수업 원본 자료 · 교육용 과제에서 인코딩·해시를 구분하는 화면.
학습 확인
이해했는지 확인하기
- Base64 값에 기밀성이 있다고 가정한 저장 항목이 없는지 확인한다.
- 파일 무결성 기준값의 출처와 알고리즘을 함께 기록한다.
- 비밀번호 저장이 전용 해시·개별 Salt·관리 가능한 비용을 사용하는지 확인한다.