Prometheus·Grafana로 상태와 이상 징후 읽기
메트릭은 시간에 따른 수치의 변화로 상태를 설명한다. 로그와 패킷을 보완하면서 수집 장애와 서비스 장애를 구분한다.
개념부터 찾아보기
정의·역할·동작 원리를 독립 페이지에서 확인하세요. 본문의 밑줄 용어에도 설명이 있습니다.


이 노트에서 설명할 수 있게 되는 것
- 스크레이프 성공과 서비스 기능의 정상 여부를 구분한다.
- Counter 증가율과 Gauge 현재값을 알맞게 해석한다.
- 라벨·구간·누락이 경보 결과에 미치는 영향을 확인한다.
01개념과 구성 요소
- Pull 수집가 의 /metrics 같은 endpoint를 주기적으로 요청한다.
- 시계열Metric 이름과 집합이 시계열을 구분하고 sample은 시각과 값을 가진다.
- 활용에 저장한 값을 로 계산하며 경보 규칙··는 다른 처리 역할을 맡는다.
02메트릭 수집부터 경보 전달까지
- 표본 노출가 · 등 정의된 의미의 측정값을 HTTP 응답으로 제공한다.
- 주기적 가 scrape_interval에 따라 요청하고 성공·실패를 up과 관련 지표로 기록한다.
- 시계열 저장 집합별 sample을 저장한다. 대상이 사라져 표본이 없는 상태와 값 0은 다르다.
- 규칙 평가evaluation_interval에 따라 식을 평가한다. 는 reset을 고려한 뒤에 목적별 집계를 적용한다.
- 경보 상태 변화조건이 지속되어 for 요건을 충족하면 pending에서 firing으로 이어질 수 있다.
- 통지 가 grouping·중복 억제·silence·수신자 routing을 적용한다. 한 통지가 원시 사건 한 건과 같지는 않다.
03Exporter→Scrape→TSDB→PromQL
- 수집·저장는 대상의 메트릭 endpoint에 주기적으로 요청하는 pull 수집 구조를 기본으로 한다. Node 는 호스트의 CPU·메모리· 등 지표를 HTTP 응답으로 제공하고 는 sample을 시계열에 저장한다.
- 는 저장된 값을 질의·시각화하는 별도 구성요소이며 나 를 대신하지 않는다.
- 실습 버전수업 자료의 2.51.0과 Node 1.7.0·1.8.2는 당시 버전 예이다. 지원 지표와 설정은 실제 버전·OS· 구성에 따라 달라질 수 있다.
04Metric 이름과 Label이 시계열을 결정한다
- 시계열 식별하나의 시계열은 metric 이름과 집합으로 구분된다. 같은 node_cpu_seconds_total도 instance·cpu·mode가 다르면 다른 시계열이다.
- Sample·Job·Instancesample은 시간과 값이다. job은 수집 구성의 묶음, instance는 기본적으로 target 식별에 쓰이는 이며 relabeling에 따라 달라질 수 있다.
- 카디널리티사용자 ID·전체 URL·요청 ID를 무제한 로 넣으면 시계열 수가 급격히 커진다. 문자열이 짧아도 조합 수가 많으면 메모리와 저장 비용이 증가한다.
- 설계로그의 모든 필드를 metric 로 옮기는 방식이 적합하지 않은 이유다.
# TYPE training_requests_total counter
training_requests_total{result="success"} 120
training_requests_total{result="failure"} 7
# TYPE training_queue_depth gauge
training_queue_depth 3
가상 endpoint의 텍스트 표현 예입니다. 와 의 의미가 다릅니다.
05scrape와 evaluation 간격의 차이
- 수집·평가 주기scrape_interval은 대상에서 새 sample을 수집하는 주기이고 evaluation_interval은 기록·경보 규칙을 평가하는 주기다. 수집이 15초이고 평가가 30초이면 모든 수집 순간마다 새 경보 판정이 실행되는 것은 아니다.
- Timeoutscrape_timeout은 요청을 기다리는 한도이며 긴 응답은 실패 sample을 만들 수 있다.
- 자기 감시 자신의 9090 job과 Node 9100 job은 수집 대상이 다르므로 분리한다. 를 추가하면서 자기 감시 job을 지우면 자체의 상태 지표를 잃는다.
- Localhost 구성아래는 같은 호스트의 교육용 구성 조각이며 컨테이너가 분리되면 localhost의 의미도 달라진다.
global:
  scrape_interval: 15s
  evaluation_interval: 30s
scrape_configs:
  - job_name: prometheus
    static_configs:
      - targets: ["localhost:9090"]
  - job_name: node
    static_configs:
      - targets: ["localhost:9100"]
원리를 설명하는 가상 학습 예시입니다.
06Counter를 rate로 읽는 이유
- 는 누적량이며 재시작 등으로 reset될 수 있다. 현재값 1000은 현재 초당 1000이라는 뜻이 아니다.
- ·Reset([5m])는 구간의 증가 추세를 초당 값으로 계산하며 reset을 고려한다. 여러 시계열을 먼저 합쳐 버리면 개별 reset의 의미가 흐려질 수 있어 각 시계열의 를 구한 뒤 목적에 맞게 집계한다.
- 는 현재 queue 깊이·온도처럼 오르내리는 값이다. 이미 비율인 값에 다시 를 적용하면 원래 질문과 달라질 수 있다.
- Sample 조건interval 안에 충분한 sample이 있어야 하고 간격·누락·짧은 구간 선택은 그래프의 안정성에 영향을 준다.
07Counter 리셋 보정과 구간 외삽
- 단조 증가는 일반적으로 증가하다 재시작 등에서 낮아질 수 있다. 단순 마지막 값−처음 값은 이런 구간에서 음수가 될 수 있다.
- 리셋 보정와 increase는 관찰한 감소를 리셋으로 다루어 증가량을 보정한다. 표본 사이에서 관찰하지 못한 모든 변화를 정확히 복원하는 것은 아니다.
- 외삽 의미함수는 선택한 시간 범위에 맞게 경계까지 외삽한다. 정수 의 increase 결과가 소수여도 오류라고 단정하지 않는다.
- 시계열별 처리서로 다른 인스턴스의 를 먼저 합치면 한쪽 리셋이 다른 증가에 가려질 수 있다. 를 각 시계열에 적용한 뒤 합산하는 이유다.
- 단위는 초당 증가량, increase는 선택 구간의 증가량이다. 같은 수식처럼 보여도 초 단위 환산 여부가 대시보드 단위를 바꾼다.
08가상 Counter 100→130→10→40의 해석
- 표본 조건0·15·30·45초에서 차례로 100·130·10·40이 관찰되었다고 가정한다. 중간에 재시작이 한 번 있었다는 교육용 모형이다.
- 첫 구간100에서 130으로 늘어 관찰 증가량은 30이다. 두 번째 구간은 값이 줄어 단순 차이 −120을 정상 증가량으로 쓰면 안 된다.
- 리셋 구간0으로 리셋된 뒤 10까지 증가했다고 보정하면 이 구간의 관찰 가능한 증가분은 10이다. 리셋 직전 미관측 증가는 알 수 없다.
- 관측 평균마지막 증가 30을 더한 보정 증가량은 70이고 표본 사이 평균은 70/45≈1.56/s다. 이것은 설명용 계산이다.
- 함수와 차이실제 결과는 조회 범위·표본 경계·외삽에 따라 이 값과 다를 수 있다. 그래프의 를 검증할 때 실제 표본 시각을 함께 본다.
090·빈 결과·급격한 증가를 구분하는 진단
- 없는 시계열값 0과 시계열 부재는 다르다. Target 제거·라벨 변경·staleness가 빈 결과를 만들 수 있다.
- 샘플 수 범위에 충분한 표본이 있는지 확인한다. 간격보다 지나치게 짧은 창은 계산 가능한 자료를 부족하게 만든다.
- 라벨 결합벡터 연산에서 라벨 집합이 맞지 않아 결과가 사라지는지 본다. 원본 양쪽 시계열이 존재해도 자동으로 모두 결합되는 것은 아니다.
- 메트릭 타입에 용 해석을 적용했는지 확인한다. 메모리 현재값처럼 정상 감소하는 자료를 리셋으로 보정하면 의미가 왜곡된다.
10CPU·메모리·네트워크 식의 단위
- CPU 시간 비율node_cpu_seconds_total의 mode=idle을 로 변환하면 각 CPU가 구간 동안 쉬었던 시간 비율에 해당한다. instance별 평균을 1에서 빼고 100을 곱하면 idle 이외 시간의 비율이다.
- 집계 범위이 값은 특정 앱의 CPU 사용률이 아니라 호스트 전체의 집계다.
- 메모리메모리 식은 MemAvailable을 사용하므로 단순 free보다 재사용 가능한 메모리를 반영한다. OS와 에 따라 지표 지원이 달라질 수 있다.
- 네트워크 단위네트워크 receive bytes 의 는 초당 바이트이며 비트/초 표시에 맞추려면 8배 단위를 명시해야 한다. loopback·가상 인터페이스를 포함할지도 분석 목적에 따라 달라진다.
(1 - avg by (instance) (
  rate(node_cpu_seconds_total{mode="idle"}[5m])
)) * 100

(1 - node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes) * 100

rate(node_network_receive_bytes_total[5m])
원리를 설명하는 가상 학습 예시입니다.
11UP과 애플리케이션 정상은 다르다
- Upup=1은 해당 가 성공했다는 뜻이고 up=0은 실패했다는 뜻이다. HTTP 서버가 /metrics에 정상 응답하더라도 실제 업무 DB 연결이 실패할 수 있다.
- 대상 부재반대로 만 중단되면 업무가 정상이어도 up=0이 된다. 최근 대상이 discovery에서 사라져 시계열 자체가 없는 상황도 0과 구분해야 한다.
- Targets 오류Targets에는 endpoint·최근 ·duration·error가 보인다. no route to 는 라우팅뿐 아니라 방화벽 reject 등으로도 발생할 수 있어 중단으로 즉시 단정하지 않는다.
- 실패 단계Connection refused, timeout, HTTP 401/403/404, 검증 오류는 서로 다른 단계의 실패이다.
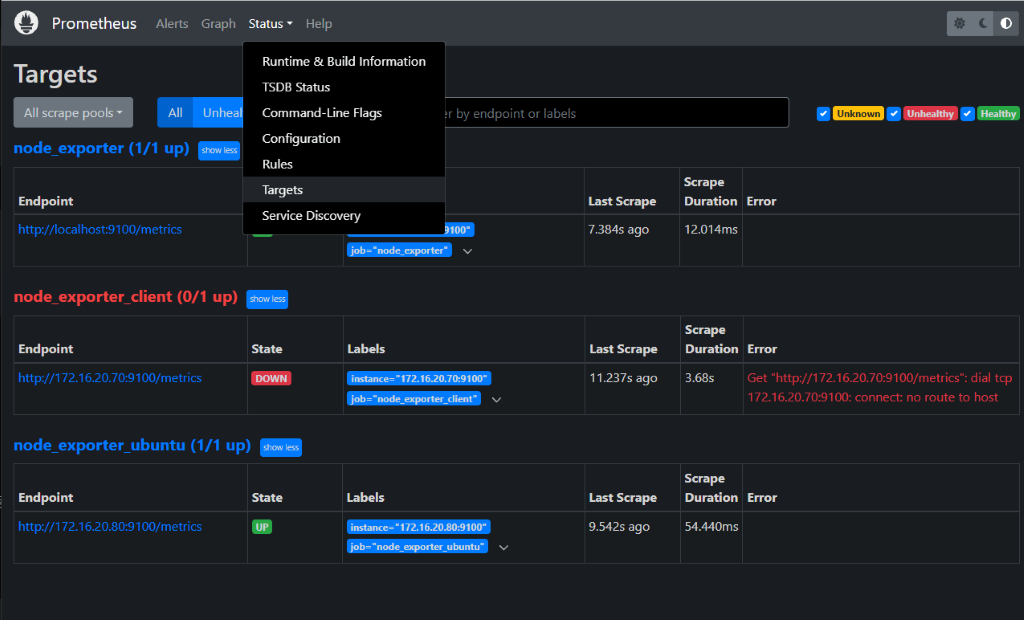
수집 성공과 실패를 Targets에서 구분하기
 원본 크기로 보기 ↗
이 자료에서 읽어낼 것
- node_exporter_client는 0/1 up이며 해당 endpoint에 대한 수집이 실패했습니다. node_exporter_ubuntu의 1/1 up과 비교해 실패 범위를 분리합니다.
- DOWN 행의 Error에 no route to host가 표시됩니다. 해당 시점의 연결 실패 단서이며 실제 경로, 연결 대상, 방화벽의 거부 응답 등 원인을 추가 확인해야 합니다.
- Last Scrape는 최근 수집 시점과의 시간, Scrape Duration은 수집 소요 시간입니다. 애플리케이션 요청의 응답 시간과 같은 지표가 아닙니다.
- UP은 수집 대상의 메트릭을 가져왔다는 상태입니다. 로그인이나 주문 같은 실제 사용자 기능까지 정상이라는 보장은 아니므로 별도의 기능 점검과 연결합니다.
Targets의 UP·DOWN을 서비스 구성과 연결하기
실행과 성공, 애플리케이션 정상 여부를 구분하고 실패 위치를 좁힌다.
실습 구성과 전제
- 자신의 격리 와 Node 를 사용한다.
- 서버별 시각·주소·포트는 실제 시험 환경에 맞추고 사진의 사설 주소로 접속하지 않는다.
Exporter 프로세스의 실행 조건을 읽는다
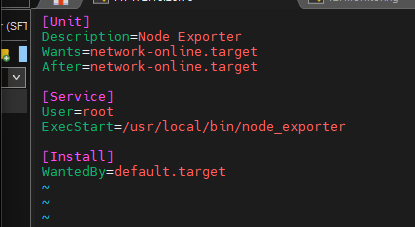
- 의 ExecStart는 실행 파일, Wants·After는 다른 유닛과의 의존·순서 조건을 나타낸다. network-online.target이 있다고 원격 대상까지 항상 연결되는 것은 아니다.
- 서비스가 active인 것과 /metrics가 올바르게 응답하는 것은 따로 확인한다.
shellsystemctl status node_exporter --no-pager curl --fail --max-time 5 http://127.0.0.1:9100/metrics자신의 에서 읽기 전용으로 조회한다.
 원본 크기로 보기 ↗
- ExecStart가 node_exporter 바이너리를 가리키며 Wants·After가 network-online.target으로 설정되어 있다.
- User=root와 WantedBy=default.target도 보인다. 실제 운영에서는 필요한 최소 권한과 활성화 대상을 따로 검토한다.
확인 기준상태·리스닝 포트·metrics 응답을 각각 확인한다.
각 job의 endpoint와 scrape 오류를 읽는다
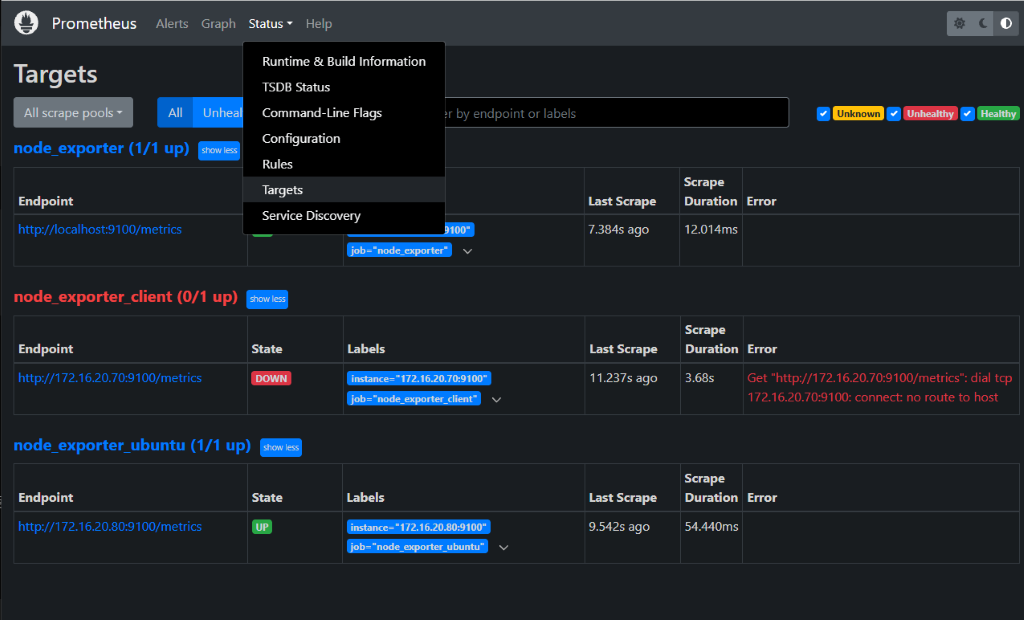
- Targets 화면의 UP은 해당 에서 메트릭을 가져왔다는 뜻이다. 호스트의 모든 서비스가 정상이라는 의미가 아니다.
- DOWN의 no route to 는 연결 경로·방화벽 거부 등 네트워크 조건을 조사할 출발점이다. 에 경로가 없다는 단일 원인으로 확정하지 않는다.
 원본 크기로 보기 ↗
- 로컬·Ubuntu job은 1/1 up이며 다른 client job은 0/1 up과 DOWN을 보여 준다.
- 실패 행에는 9100/metrics endpoint, scrape duration 3.68s, no route to host 메시지가 함께 나타난다.
확인 기준서버에서 같은 endpoint를 확인해야 하며 브라우저 PC의 접속 결과로 대체하지 않는다.
설정 대상과 지표 의미를 재검증한다
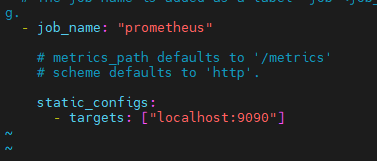
- static_configs.targets가 의도한 를 가리키는지 본다. 자체의 9090과 Node 의 9100은 서로 다른 수집 대상이다.
- 경로를 수정한 뒤 UP 변화를 확인하고 실제 node 메트릭의 이름·단위·라벨을 조사한다.
textup node_uname_info조회 예시. up과 노드 정보 메트릭은 서로 다른 확인 항목이다.
 원본 크기로 보기 ↗
- job_name은 prometheus이고 target은 localhost:9090이다.
- metrics_path와 scheme은 주석으로 기본값을 설명한다. 이 항목을 Node Exporter 연결 성공 증거로 쓰면 안 된다.
확인 기준UP 회복 뒤에도 실제 필요한 메트릭이 존재하는지 별도로 확인한다.
실습에서 확인한 동작 원리
- UP은 수집 성공 지표다.
- 문제 확인은 실제 수집 주체인 서버 위치에서 수행한다.
설정·출력 추가로 확인하기 30장
아래 화면을 펼쳐 위 실습의 설정값, 명령과 확인 기준을 비교해 보세요. 각 묶음은 별도 실습 기록입니다.
실습 화면 묶음 01 1장
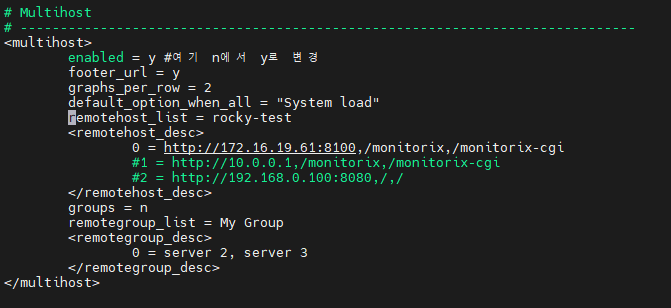 원본 크기로 보기 ↗
- 「이게 무슨 의미인가?」 문맥에 삽입된 원본 실습·개념 참고 화면이다. Prometheus·Grafana로 상태와 이상 징후 읽기 학습 내용과 함께 당시 구성·설정·관찰 결과를 비교할 수 있다.
실습 화면 묶음 02 25장
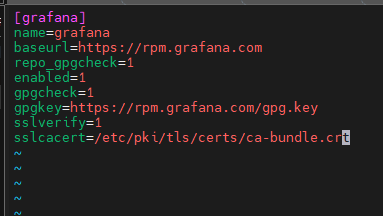 원본 크기로 보기 ↗
- 수업 원본 자료 · 서비스 등록·수집 대상·Exporter·대시보드 연결. 원문에서 「Grafana 시각화 서버 구축 & 연동」에 배치된 그림 또는 화면이다.
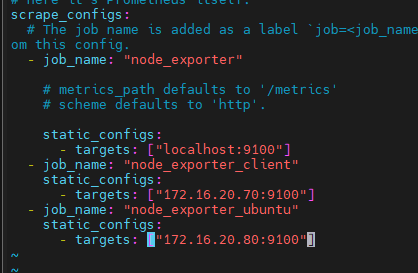 원본 크기로 보기 ↗
- 수업 원본 자료 · 서비스 등록·수집 대상·Exporter·대시보드 연결. 원문에서 「중앙 프로메테우스 서버 설정 — 타겟 추가」에 배치된 그림 또는 화면이다.
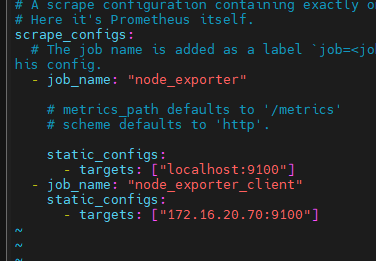 원본 크기로 보기 ↗
- 수업 원본 자료 · 서비스 등록·수집 대상·Exporter·대시보드 연결. 원문에서 「중앙 프로메테우스 서버 설정 변경 — 타겟 추가」에 배치된 그림 또는 화면이다.
 원본 크기로 보기 ↗
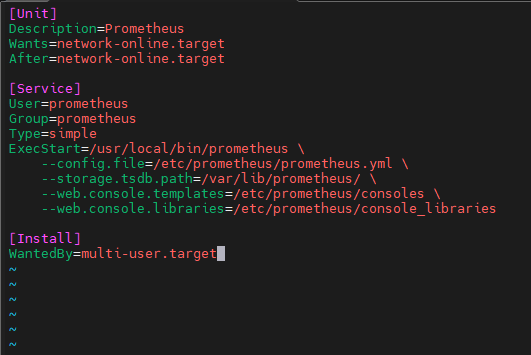
- 수업 원본 자료 · 서비스 등록·수집 대상·Exporter·대시보드 연결. 원문에서 「프로메테우스 데몬 등록 및 실행 (systemd)」에 배치된 그림 또는 화면이다.
 원본 크기로 보기 ↗
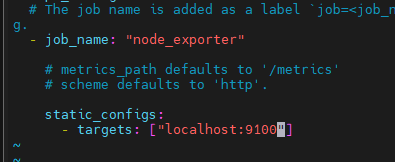
- 수업 원본 자료 · 서비스 등록·수집 대상·Exporter·대시보드 연결. 원문에서 「프로메테우스 설정 파일 수정 — Pull 대상 등록」에 배치된 그림 또는 화면이다.
 원본 크기로 보기 ↗
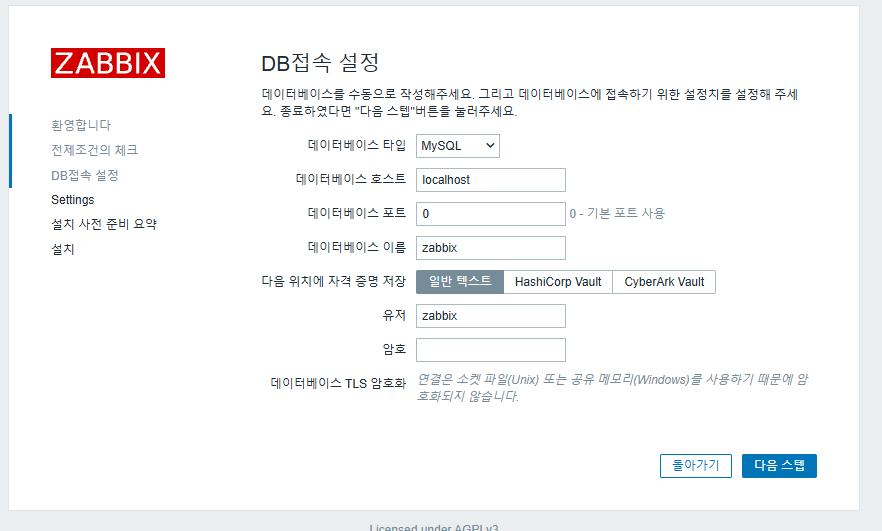
- 수업 원본 자료 · 모니터링 서버·웹 프런트엔드·호스트·에이전트 연결.
 원본 크기로 보기 ↗
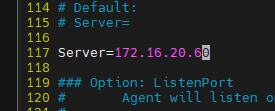
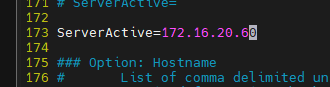
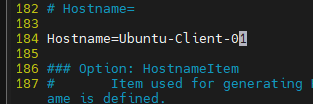
- 수업 원본 자료 · 모니터링 서버·웹 프런트엔드·호스트·에이전트 연결. 원문에서 「설정 파일 수정」에 배치된 그림 또는 화면이다.
 원본 크기로 보기 ↗
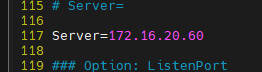
- 수업 원본 자료 · 모니터링 서버·웹 프런트엔드·호스트·에이전트 연결. 원문에서 「설정 파일 수정」에 배치된 그림 또는 화면이다.
 원본 크기로 보기 ↗
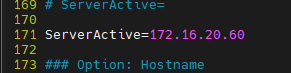
- 수업 원본 자료 · 모니터링 서버·웹 프런트엔드·호스트·에이전트 연결. 원문에서 「설정 파일 수정」에 배치된 그림 또는 화면이다.
 원본 크기로 보기 ↗
- 수업 원본 자료 · 모니터링 서버·웹 프런트엔드·호스트·에이전트 연결. 원문에서 「설정 파일 수정 — zabbix_agentd.conf」에 배치된 그림 또는 화면이다.
 원본 크기로 보기 ↗
- 수업 원본 자료 · 모니터링 서버·웹 프런트엔드·호스트·에이전트 연결. 원문에서 「설정 파일 수정 — zabbix_agentd.conf」에 배치된 그림 또는 화면이다.
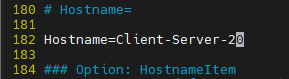 원본 크기로 보기 ↗
- 수업 원본 자료 · 모니터링 서버·웹 프런트엔드·호스트·에이전트 연결. 원문에서 「설정 파일 수정 — zabbix_agentd.conf」에 배치된 그림 또는 화면이다.
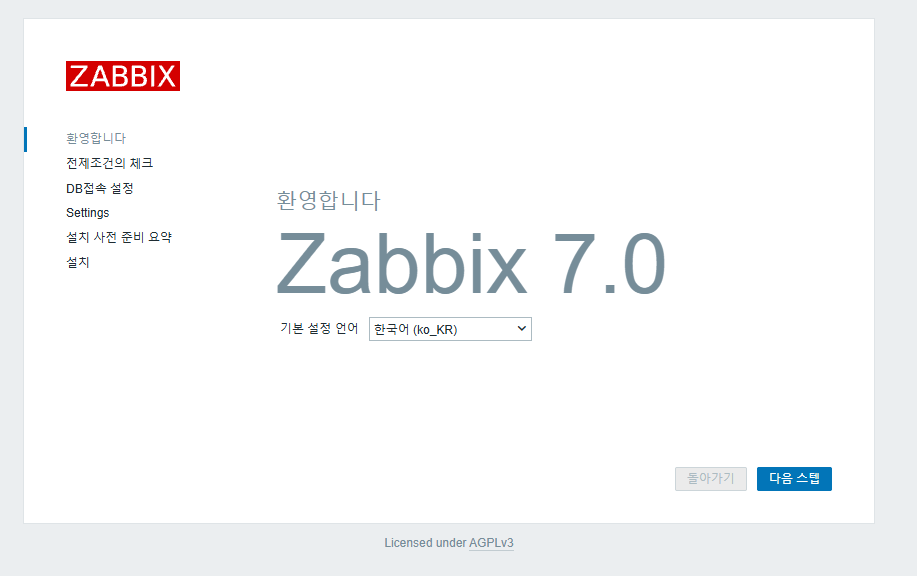 원본 크기로 보기 ↗
- 수업 원본 자료 · 모니터링 서버·웹 프런트엔드·호스트·에이전트 연결. 원문에서 「웹 설치 마법사로 프론트엔드 구성」에 배치된 그림 또는 화면이다.
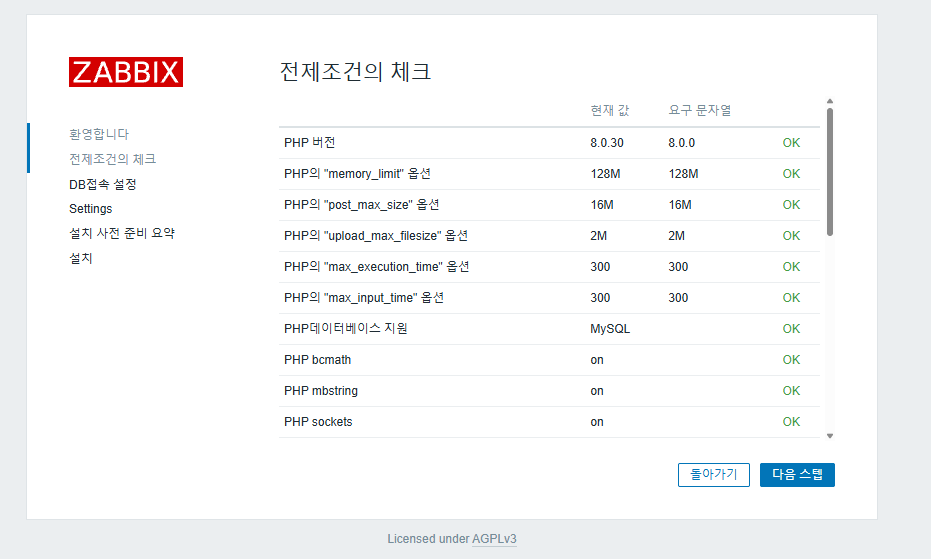 원본 크기로 보기 ↗
- 수업 원본 자료 · 모니터링 서버·웹 프런트엔드·호스트·에이전트 연결. 원문에서 「웹 설치 마법사로 프론트엔드 구성」에 배치된 그림 또는 화면이다.
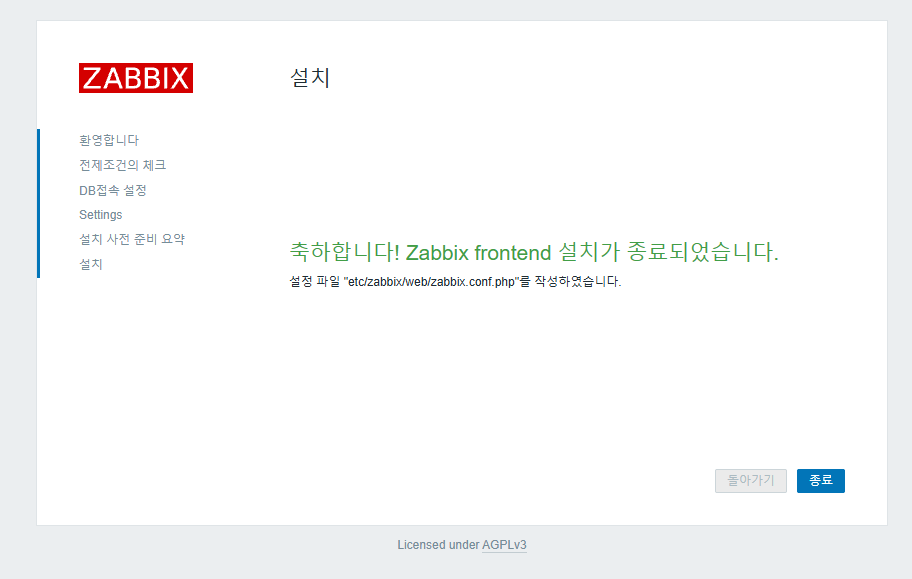 원본 크기로 보기 ↗
- 수업 원본 자료 · 모니터링 서버·웹 프런트엔드·호스트·에이전트 연결. 원문에서 「웹 설치 마법사로 프론트엔드 구성」에 배치된 그림 또는 화면이다.
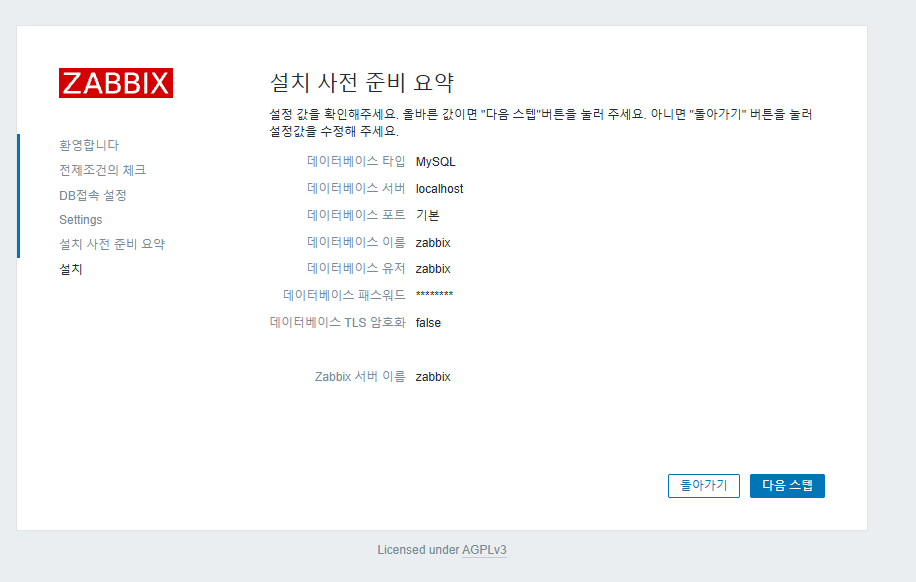 원본 크기로 보기 ↗
- 수업 원본 자료 · 모니터링 서버·웹 프런트엔드·호스트·에이전트 연결. 원문에서 「웹 설치 마법사로 프론트엔드 구성」에 배치된 그림 또는 화면이다.
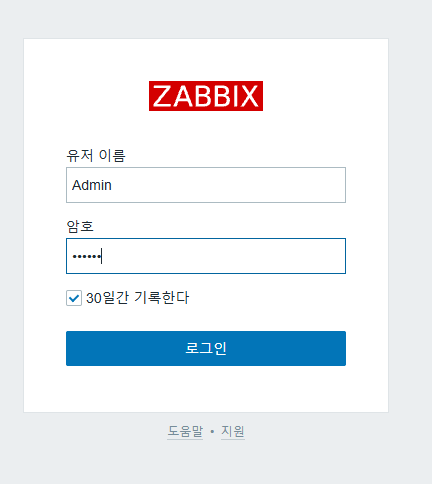 원본 크기로 보기 ↗
- 수업 원본 자료 · 모니터링 서버·웹 프런트엔드·호스트·에이전트 연결. 원문에서 「웹 설치 마법사로 프론트엔드 구성」에 배치된 그림 또는 화면이다.
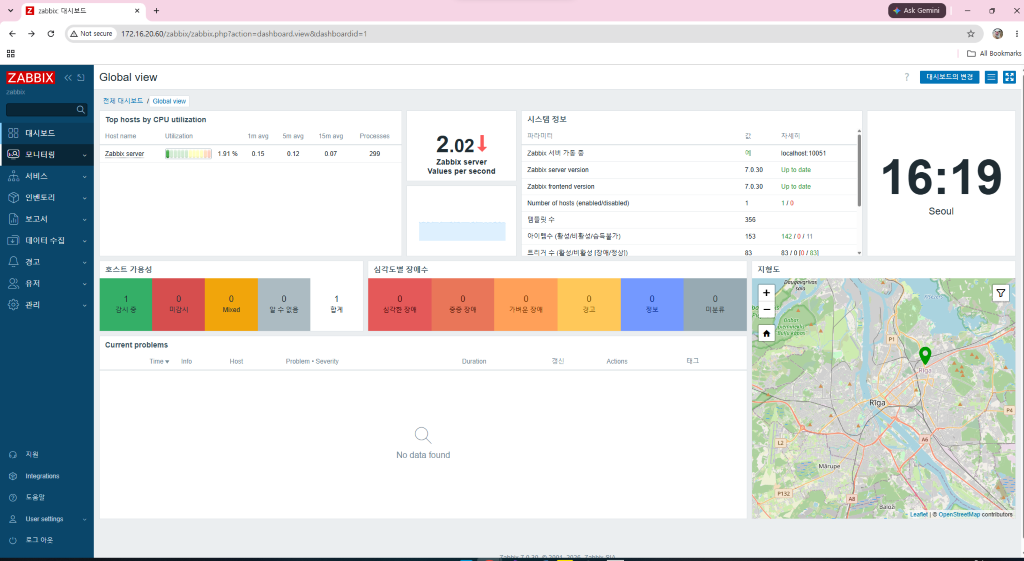 원본 크기로 보기 ↗
- 수업 원본 자료 · 모니터링 서버·웹 프런트엔드·호스트·에이전트 연결. 원문에서 「웹 설치 마법사로 프론트엔드 구성」에 배치된 그림 또는 화면이다.
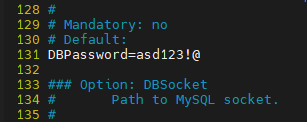 원본 크기로 보기 ↗
- 수업 원본 자료 · 모니터링 서버·웹 프런트엔드·호스트·에이전트 연결. 원문에서 「자빅스 서버 환경설정 & 방화벽 & 서비스 실행」에 배치된 그림 또는 화면이다.
 원본 크기로 보기 ↗
- 수업 원본 자료 · 모니터링 서버·웹 프런트엔드·호스트·에이전트 연결. 원문에서 「클라이언트(호스트) 정보 등록」에 배치된 그림 또는 화면이다.
 원본 크기로 보기 ↗
- 수업 원본 자료 · 모니터링 서버·웹 프런트엔드·호스트·에이전트 연결. 원문에서 「클라이언트(호스트) 정보 등록」에 배치된 그림 또는 화면이다.
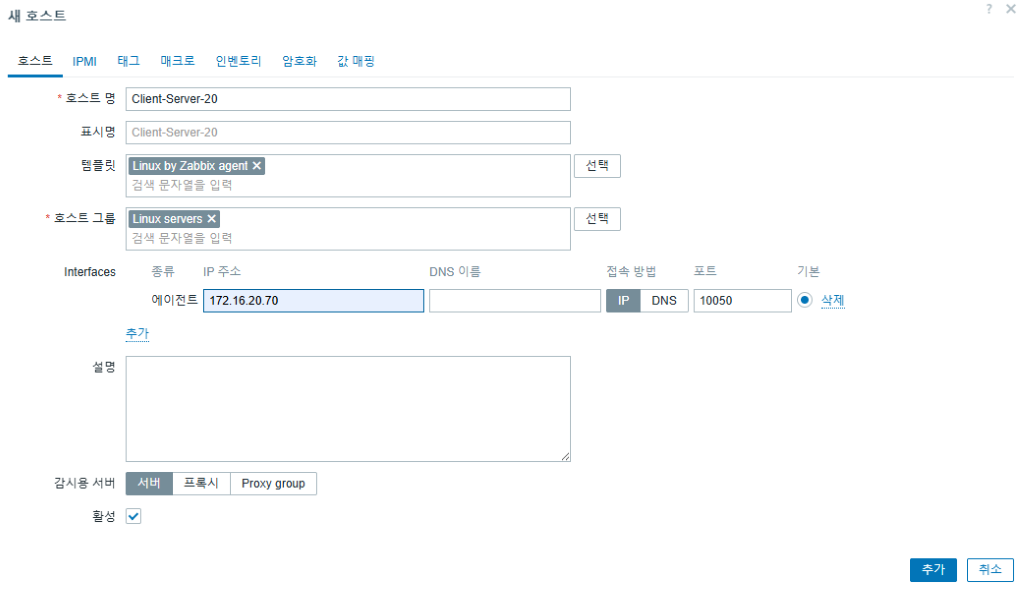 원본 크기로 보기 ↗
- 수업 원본 자료 · 모니터링 서버·웹 프런트엔드·호스트·에이전트 연결. 원문에서 「클라이언트(호스트) 정보 등록」에 배치된 그림 또는 화면이다.
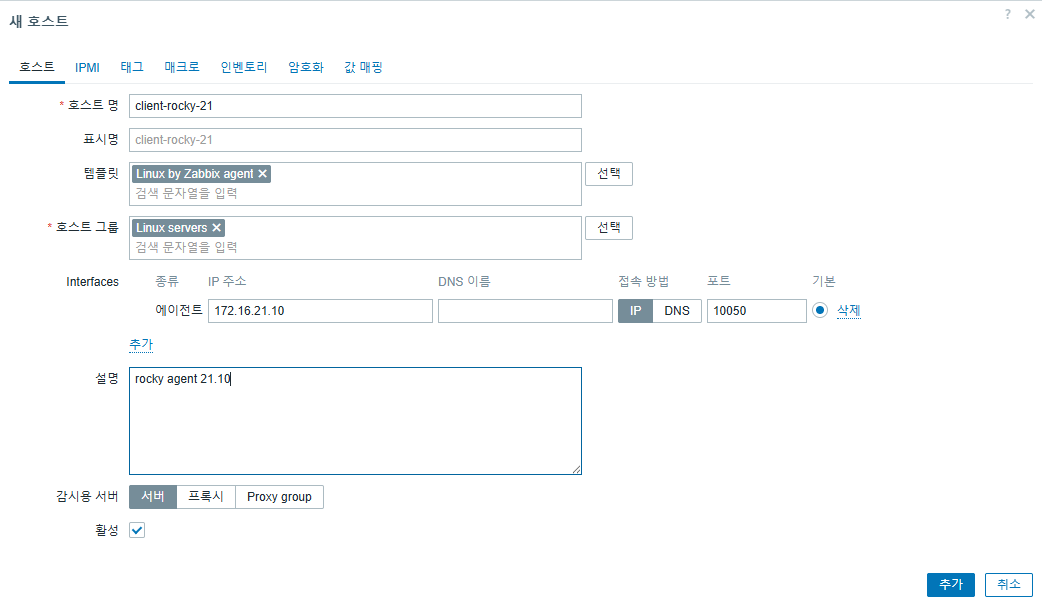 원본 크기로 보기 ↗
- 수업 원본 자료 · 모니터링 호스트와 에이전트 등록 화면. 원문에서 「자빅스 에이전트 등록 (UI)」에 배치된 그림 또는 화면이다.
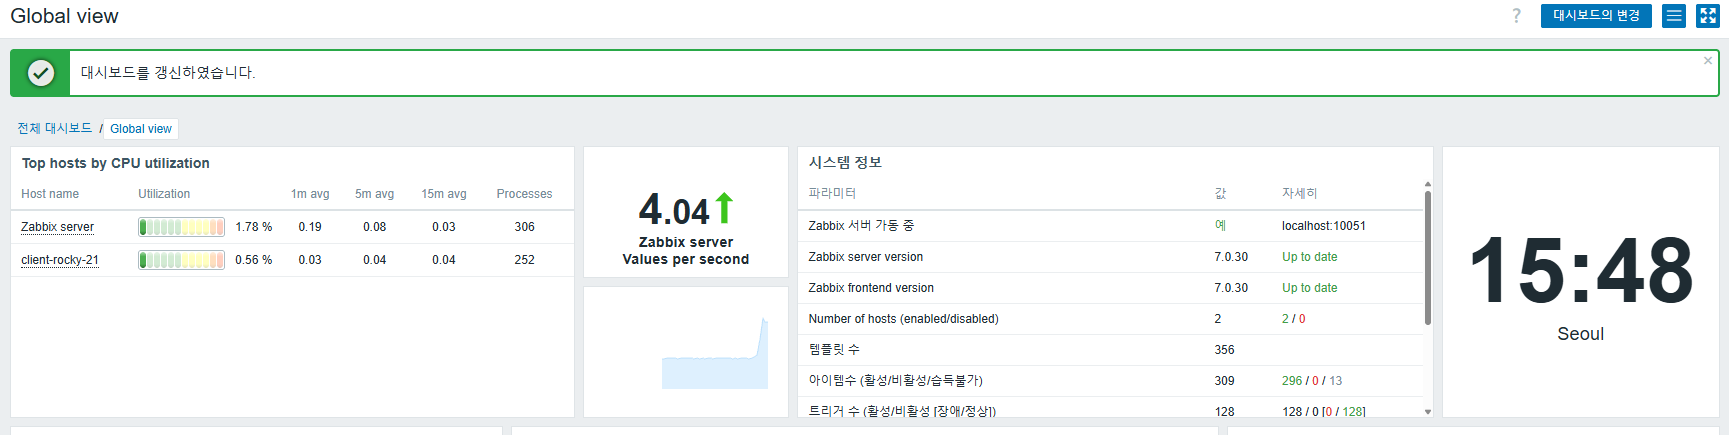 원본 크기로 보기 ↗
- 수업 원본 자료 · 모니터링 호스트와 에이전트 등록 화면. 원문에서 「자빅스 에이전트 등록 (UI)」에 배치된 그림 또는 화면이다.
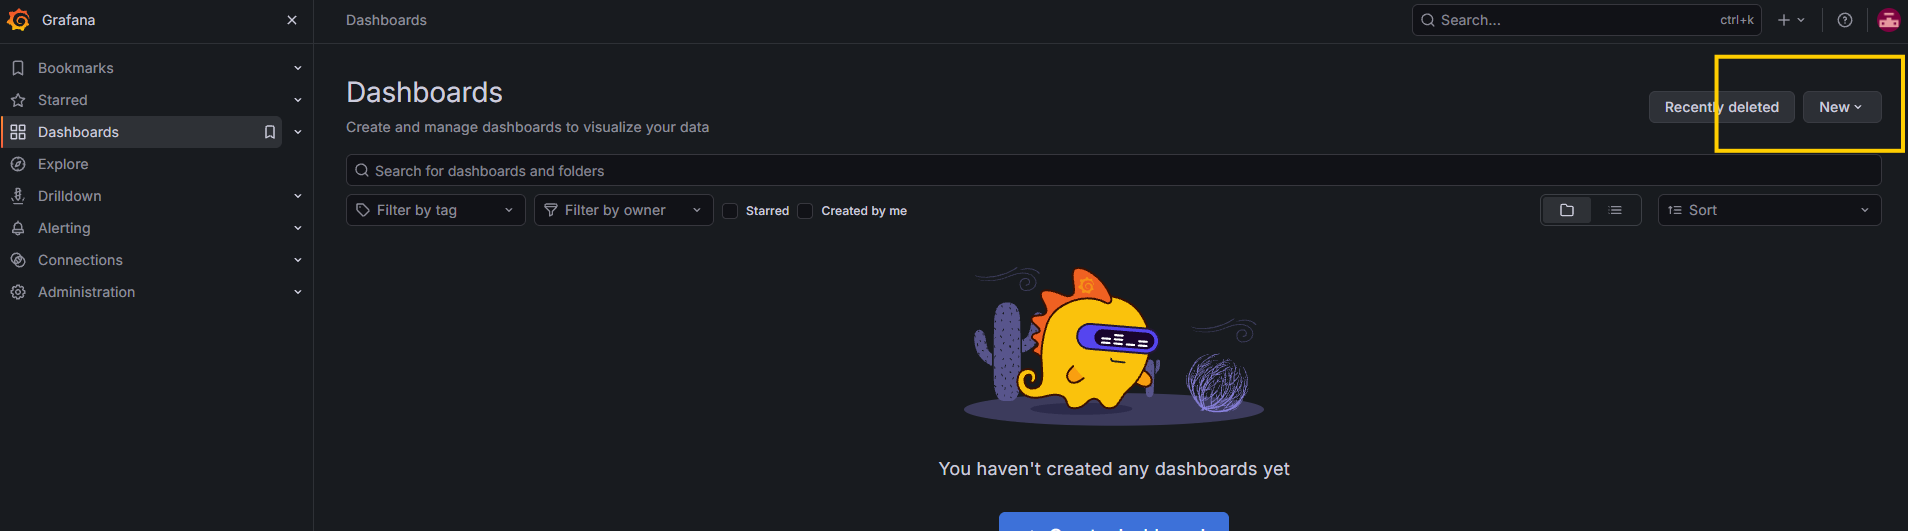 원본 크기로 보기 ↗
- 수업 원본 자료 · 모니터링 호스트와 에이전트 등록 화면. 원문에서 「자빅스 에이전트 등록 (UI)」에 배치된 그림 또는 화면이다.
실습 화면 묶음 03 1장
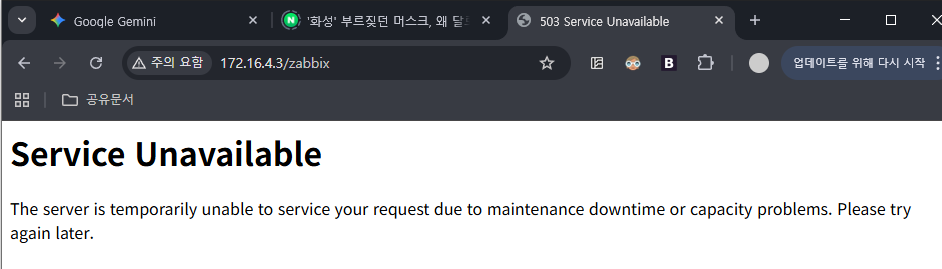 원본 크기로 보기 ↗
- 학습 원본 · Zabbix 설치와 DB 연결의 해당 절에 수록된 화면·도식이다.
실습 화면 묶음 04 1장
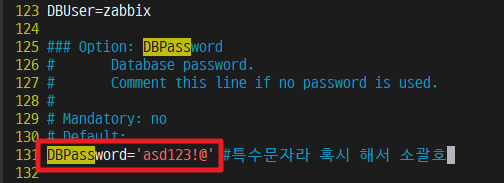 원본 크기로 보기 ↗
- 학습 원본 · Zabbix 설치와 DB 연결의 해당 절에 수록된 화면·도식이다.
실습 화면 묶음 05 1장
 원본 크기로 보기 ↗
- 학습 원본 · Zabbix 설치와 DB 연결의 해당 절에 수록된 화면·도식이다.
실습 화면 묶음 06 1장
 원본 크기로 보기 ↗
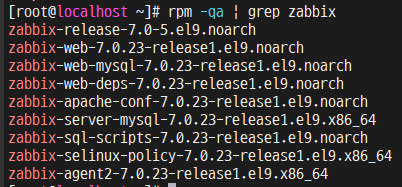
- 학습 원본 · Zabbix 설치와 DB 연결의 해당 절에 수록된 화면·도식이다.
12Prometheus 서버 관점과 Grafana 서버 관점
- 경로메트릭 요청은 서버가 수행한다. 사용자 브라우저에서 주소가 열린다고 같은 경로가 에도 있다는 뜻은 아니다.
- 경로 검사 역시 서버·컨테이너에서 로의 요청이다. 두 단계에서 localhost가 각각 가리키는 대상이 다르다.
- 빈 패널UP인데 패널이 비어 있다면 collector가 해당 metric을 내보내는지, 필터·job 변수·조회 기간·단위가 맞는지 확인할 수 있다. Community dashboard는 특정 지표와 변수를 가정하므로 모든 환경에서 패널이 자동으로 채워지는 것은 아니다.
13경보 상태와 Alertmanager
- Pending·Firing가 경보 식을 평가하고 조건이 지속되면 pending에서 firing으로 이어질 수 있다. for 기간은 순간적인 흔들림을 줄이는 조건이지만 실제 장애 통보도 그만큼 늦출 수 있다.
- Absent 처리수집 대상 누락과 값 0을 구분하지 못한 식은 원래 감시하려던 장애에서 아무 경보도 만들지 않을 수 있다.
- 는 전달받은 경보의 grouping·중복 억제·silence·수신자 routing을 담당한다. 통지 한 건이 원시 이벤트 한 건과 같은 수량은 아니다.
- 경보 전달 추적경보가 발생하지 않는 문제를 수집 식·규칙 평가· 전달·routing·수신 단계로 분해한다.
14WAL·Head·Block과 보존
- Head··Block최근 sample은 head 영역과 등 저장 구조에서 관리되고 시간이 지나면 block으로 정리된다. 보존 기간, 간격, 활성 시계열 수와 조합이 필요한 저장량에 영향을 준다.
- 파일 관리실행 중인 데이터 파일을 임의로 삭제하는 것은 안전한 보존 정책 적용과 다르다.
- 그래프 상태그래프의 값 0·sample 없음·조회 범위 밖· 조건 불일치는 서로 다른 상태다. 지표를 조회할 수 있는 상태와 지표가 질문에 맞는 의미를 가진 상태를 분리해야 모니터링 화면을 장애 원인 설명에 사용할 수 있다.
설명과 함께 보는 보조 도식
메트릭 표본과 두 소비 경로
저장된 시계열을 그래프와 경보가 각각 소비하는 모식도다.
메트릭 읽기
대상 응답과 수집 성공 여부를 확인한다.
- up
- 스크레이프 성공 여부
전체 단계를 한 번에 읽기
- 01
메트릭 읽기
대상 응답과 수집 성공 여부를 확인한다.
- up
- 스크레이프 성공 여부
- 02
시계열 저장
메트릭 이름과 라벨 조합이 시계열을 구분한다.
- 03
구간 계산
Counter 증가율이나 지연 분포를 계산한다.
- 04
그래프 조회
표시 시간 범위와 수집 공백을 함께 읽는다.
- 05
경보 전달
조건이 충족된 경보를 알림 처리 경로로 보낸다.
함께 보는 학습 자료
아래 공식 자료를 본문의 개념·예제와 함께 읽어 보세요. 자료별로 확인할 위치와 관찰할 내용을 적었습니다.
Prometheus: Histogram·Summary의 합과 개수
관측 합과 개수로 평균을 계산하는 공식과 classic·native histogram의 표현 차이를 비교한다.
- classic _sum·_count와 의 결합
- 관측값이 음수일 때 _sum의 가정 문제
- bucket 기반 quantile과 Summary quantile의 집계 차이
이해했는지 확인하기
- 대상 수집 상태와 Grafana 시간 범위·데이터 소스를 확인한다.
- Counter·Gauge와 단위·라벨 조합을 구분한다.
- 경보 발생·해제·수집 실패를 각각 시험한다.