RAID
레이드 · Redundant Array of Independent Disks
는 여러 디스크에 데이터를 분산하거나 복제·패리티를 저장하여 성능과 장치 장애 대응을 조합하는 방식이다. 레벨마다 배치·가용 용량·허용 고장이 다르며 정상 배열도 잘못된 삭제를 과거 상태로 되돌려 주지는 않는다.
밑줄 용어에 마우스를 올리거나, 키보드로 선택하거나, 터치하면 설명을 볼 수 있습니다.
01무엇이고, 어떤 일을 하나
- 스트라이핑으로 여러 장치에 I/O를 분산한다.
- 미러링 또는 패리티로 정해진 범위의 장치 손실에 대비한다.
- degraded·recovery 등 배열 상태를 통해 재구축 과정을 관리한다.
02어떤 순서로 동작하나
- 블록 배치
선택한 레벨에 따라 논리 블록을 멤버 장치에 분산·복제하고 필요한 패리티를 계산한다.
- 정상 읽기와 쓰기
읽기·쓰기 요청을 실제 멤버 I/O로 바꾸며 패리티 배열의 작은 쓰기는 추가 읽기와 갱신이 필요할 수 있다.
- 장치 손실 대응
미러·패리티가 있는 배열에서 허용 범위 안의 멤버 손실은 남은 자료로 요청을 처리하며 degraded 상태가 된다. 은 중복 정보가 없어 같은 방식으로 장치 손실을 견디지 못한다.
- 재구축
교체 장치에 데이터를 다시 만들어 기록한다. 남은 장치의 읽기 가능성과 추가 오류 여부가 복구 성공에 영향을 준다.
03먼저 알아둘 용어와 구성요소
- 같은 크기 디스크 두 개에 을 만들면 연속 데이터 구간을 chunk로 나누어 A0,B0,A1,B1처럼 번갈아 배치한다.
- 은 같은 논리 블록을 두 장치에 기록한다.
- 는 한 stripe의 데이터로부터 패리티를 계산해 여러 디스크에 분산한다.
- 은 서로 독립적인 두 패리티 정보를 사용해 두 장치 장애를 견딘다.
- 전형적인 네 디스크 은 두 미러 쌍 위에 stripe를 놓는다.
- 데이터와 패리티 갱신 도중 전원이 끊기면 두 상태가 어긋날 수 있다. MD의 journal·PPL 같은 일관성 정책은 이런 갱신 경계를 다루며 단순 파일 백업과 목적이 다르다.
RAID 1의 정상·저하·멤버 교체 상태 읽기
같은 MD 배열의 멤버 수와 역할을 추적해, 데이터가 읽히는 상태와 중복성이 복구된 상태를 구별한다.
실습 구성과 전제
- 화면은 가상 디스크로 만든 배열 /dev/md1의 장애 주입 및 멤버 교체 실습이다. 실제 운영 장치에 장애 명령을 적용하지 않는다.
- 세 화면은 배열 식별 정보와 멤버 표를 대조해 읽는다. 아래에서는 조회 명령만 제시한다.
정상 배열의 기준을 기록한다
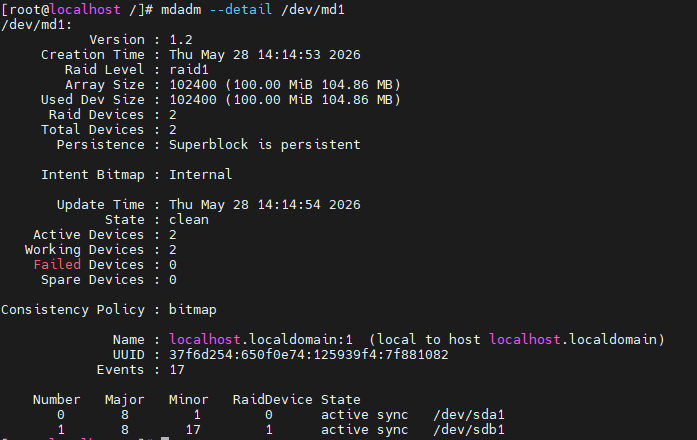
- Level이 raid1이고 두 멤버가 active sync라면 같은 논리 데이터를 두 장치에 유지하는 구성을 읽을 수 있다. usable 용량은 두 디스크 용량의 단순 합이 아니다.
- State뿐 아니라 Devices, Active Devices, Failed Devices, 멤버 역할을 기록해야 이후 변화가 분명해진다.
bashsudo mdadm --detail /dev/md1 cat /proc/mdstat배열 상태와 커널의 MD 요약을 조회한다.
 원본 크기로 보기 ↗
- 배열 상태는 clean, Active Devices는 2, Failed Devices는 0이다.
- sda1과 sdb1이 각각 active sync로 표시되고 배열 크기는 약 100MiB다.
확인 기준clean 한 단어만 확인하지 말고 기대 멤버 수와 실제 active 수가 일치하는지 본다.
장애 이후 읽기 가능성과 중복성 손실을 분리한다
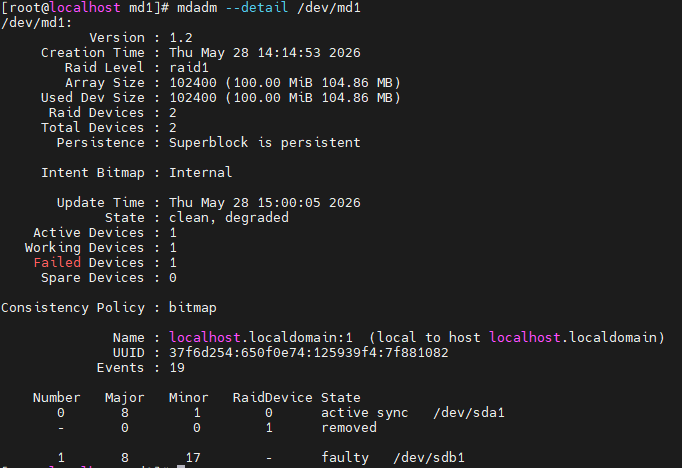
- 장애를 주입한 뒤 State는 clean, degraded로 바뀐다. surviving 멤버가 남아 서비스가 이어질 수 있지만 추가 장애에 대한 보호는 줄어든다.
- clean은 기록된 배열 상태를 설명하며, degraded와 함께 나올 수 있다. 파일이 읽힌다는 사실만으로 두 복제본이 모두 정상이라고 판단하지 않는다.
 원본 크기로 보기 ↗
- Active Devices는 1, Failed Devices는 1로 바뀐다.
- sdb1은 faulty로, 한 RAID 슬롯은 removed로 나타나고 sda1이 active sync로 남아 있다.
확인 기준이 실습의 faulty 표시는 의도한 장애 주입 결과다. 실제 장치 고장 원인을 이 화면만으로 진단한 것은 아니다.
교체 후 배열 참여와 재동기화 완료를 확인한다
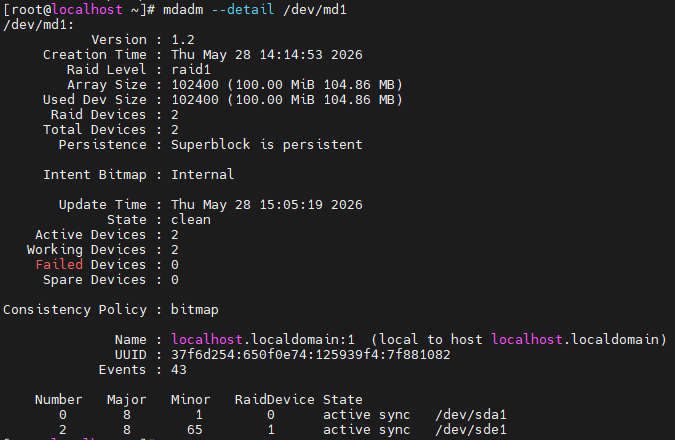
- 새 장치를 추가하면 재구축 중 상태를 거쳐 동기화된 멤버가 된다. 두 번째 장치를 인식했다는 사실만으로 복구가 끝났다고 판단하지 않는다.
- 마지막 화면은 sde1이 active sync로 참여하고 Active Devices 2, Failed Devices 0으로 돌아온 결과를 보여 준다. 재구축 진행률 자체는 이 정지 화면에 보이지 않는다.
 원본 크기로 보기 ↗
- sda1과 sde1이 active sync로 나열된다.
- State는 clean이고 Active Devices=2, Failed Devices=0으로 표시된다.
확인 기준멤버 수와 역할, /proc/mdstat의 재동기화 표시, 파일 시스템 접근을 모두 확인한다. 는 실수 삭제까지 되돌리는 백업이 아니다.
실습에서 확인한 동작 원리
- 은 한 멤버가 고장 나도 동작할 수 있지만 degraded 동안 중복 보호가 약해진다.
- 장치 추가, 재구축 진행, active sync 복귀는 서로 다른 상태이며 백업 복원과도 다르다.
동작·명령 참고 문서
04예제로 따라가기
- 동일 크기 N개 장치의 는 일반적인 계산에서 (N−1)개 분량이 데이터 용량이며 단일 장치 손실을 견딘다.
- 미러 쌍 두 개 위의 에서 서로 다른 쌍의 한 장치씩 고장난 경우와 같은 쌍 두 장치가 고장난 경우는 복구 가능성이 다르다.
- 축약한 단일 XOR 패리티 모델에서 P=A XOR B라면 A를 잃었을 때 P XOR B로 복원하지만 A와 B를 함께 잃으면 패리티 하나로 두 값을 정할 수 없다.
05혼동하기 쉬운 점과 확인 기준
- check에서 불일치가 발견됐다고 어느 복사본이 올바른 업무 데이터인지 자동 확정되는 것은 아니다. 컨트롤러·전원·장치 오류와 백업 근거가 필요하다.
- 재구축은 남은 장치를 많이 읽는다. 그중 필요한 블록이 읽히지 않으면 단순한 장치 수 계산보다 복구 조건이 나빠질 수 있다.
- 모든 멤버가 정상이어도 사용자의 삭제는 정상 쓰기로 반영될 수 있다. 이 경우 필요한 것은 장애 멤버 교체가 아니라 삭제 전 시점의 백업 복원이다.
06상세 노트 · 실습 자료
헤더 구조, 설정 예시, 수치 계산과 수업 캡처는 아래 노트에서 이어집니다.
공식 문서 · 표준
기초 개념과 동작 설명을 대조한 자료입니다. 제품 버전과 실제 설정에 따른 차이는 본문 및 원문에서 확인하세요.