Python 함수·스코프·클로저
파이썬 함수 · Python 함수
는 호출할 수 있는 코드와 필요한 환경을 묶는 객체이다. def 실행 시 함수 객체를 만들고 호출 시 인자를 지역 이름에 연결하며 스코프·기본값·가 값의 평가 시점을 결정한다.
밑줄 용어에 마우스를 올리거나, 키보드로 선택하거나, 터치하면 설명을 볼 수 있습니다.
01무엇이고, 어떤 일을 하나
- 입력·반환·부작용의 경계를 만들어 반복 로직을 재사용한다.
- 지역·둘러싼 함수·모듈·내장 이름의 조회 범위를 구분한다.
- 함수 전달··generator로 실행과 상태 보존을 구성한다.
02어떤 순서로 동작하나
- 정의 실행
def가 함수 객체를 만들고 기본값 표현식 등을 그 시점에 평가한다.
- 인자 바인딩
호출 시 위치·키워드 인자를 매개변수 규칙에 맞춰 연결하며 중복·누락은 본문 전에 오류가 될 수 있다.
- 본문 수행
지역 이름과 외부 바인딩을 규칙에 따라 조회하며 객체 변경·호출·분기를 수행한다.
- 반환·재개
return이 결과를 호출자에게 전달한다. generator는 호출 즉시 본문 전체를 수행하지 않고 순회에 따라 중단·재개한다.
03먼저 알아둘 용어와 구성요소
- *args는 남은 위치 인자를 tuple로, **kwargs는 남은 키워드 인자를 dict로 모은다.
- 함수 정의의 / 앞은 위치 전용, * 뒤는 키워드 전용 매개변수로 만들 수 있다.
- 기본값 표현식은 일반적으로 def가 실행될 때 평가되어 함수 객체에 보관된다.
- 일반적인 함수의 이름 조회는 Local, Enclosing, Global, Built-in 순서로 설명한다.
- global은 모듈 수준 이름의 재대입, nonlocal은 둘러싼 함수 범위의 기존 이름 재대입을 가리킨다.
- 는 내부 함수가 둘러싼 함수의 필요한 이름 바인딩을 참조하여 바깥 호출이 끝난 뒤에도 그 환경을 사용하는 구조다.
반복 종료를 함수의 입력·반환값으로 재구성하기
range의 종료값, 루프의 break, 함수의 return이 바꾸는 실행 위치를 구분한다.
실습 구성과 전제
- 사진은 range 표현과 카운터 반복의 독립 사례다. 아래 함수는 이 반복을 입력과 반환값이 있는 형태로 재구성한 코드다.
- 에서 실행하는 예시다. 화면에 없는 함수 실행을 실제 촬영 결과로 주장하지 않고 예상 출력을 따로 표시한다.
range의 표현과 실제 반복 값을 구별한다
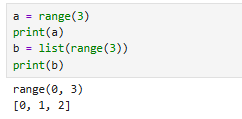
- range(3)은 0부터 3 미만의 정수를 표현하는 객체다. range 객체를 출력한 문자열과 list로 변환한 결과는 다른 표현이다.
- for는 해당 객체를 순회하면서 값을 차례로 받는다. 종료 경계 3이 포함되지 않으므로 이 예시에서 본문을 최대 세 번 수행한다.
 원본 크기로 보기 ↗
- range(3)을 직접 출력하면 range(0, 3)이 표시된다.
- list(range(3))은 [0, 1, 2]로 출력되어 종료값 3이 제외됨을 보여 준다.
확인 기준종료값을 포함하는 횟수로 계산하지 않는다. 시작·끝·간격과 break 같은 별도 종료 조건을 나누어 읽는다.
카운터 증가와 break의 위치를 추적한다
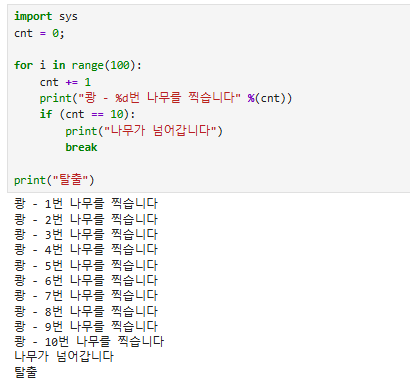
- 두 번째 사진은 반복에서 카운터를 증가·출력한 뒤 10이면 break한다. range(100)의 모든 값을 쓰지 않고 조건이 만족된 시점에 가장 가까운 루프를 끝낸다.
- 루프 밖의 출력이 이어지므로 break가 프로그램 전체나 함수 전체를 끝내는 명령이 아님을 확인할 수 있다.
 원본 크기로 보기 ↗
- for range(100) 내부에서 cnt를 1씩 늘리고 cnt==10에서 break한다.
- 화면에는 열 번의 반복 출력 뒤 루프 밖의 탈출 메시지가 보인다.
확인 기준증가·출력·조건 검사 순서가 달라지면 마지막으로 출력되는 값과 수행 횟수가 달라진다.
함수 입력과 반환값으로 결과를 명확히 전달한다
- 재구성 함수는 limit을 받아 그만큼 반복한 뒤 실제 처리 횟수를 반환한다. break는 루프를 끝내고, 뒤의 return은 현재 함수 호출을 끝내며 호출자에게 count를 전달한다.
- 반환값 없이 print만 하는 함수는 호출자가 결과를 계산에 쓰기 어렵다. 출력 효과와 반환값을 분리하면 반복 코드를 자동화 작업에 재사용할 수 있다.
def count_until(limit):
    if not 1 <= limit <= 100:
        raise ValueError("limit must be 1..100")
    count = 0
    for _ in range(100):
        count += 1
        if count == limit:
            break
    return count

result = count_until(10)
print(result)  # 10
정수 limit을 입력하는 학습용 재구성 함수다. 사진의 반복을 함수 경계와 반환값으로 확장했다.
확인 기준예상 결과는 10이다. limit이 허용 범위를 벗어나면 반복을 시작하기 전에 ValueError로 조건 위반을 분리한다.
실습에서 확인한 동작 원리
- range의 끝은 제외되며 반복 중 break가 있으면 전체 수열을 끝까지 소비하지 않을 수 있다.
- break와 return은 이동하는 실행 경계가 다르므로 함수의 입력·상태·출력을 분리해서 추적한다.
동작·명령 참고 문서
장비 자동화의 메뉴·원격 명령·결과 파일을 한 흐름으로 읽기
사용자 입력을 명령으로 바꾸고 결과를 저장하는 자동화 구조에서 실제 성공의 근거를 구별한다.
실습 구성과 전제
- 흐름도, 장비 설정 메뉴, Jupyter 결과 폴더는 서로 다른 실행 화면이다. 하나의 요청이 모두를 거쳤다고 단정하지 않는다.
- 실습 장비와 검증한 SSH 호스트 키, 최소 권한 인증 키가 준비된 환경을 가정한다. 아래 코드는 조회 전용으로 재구성한다.
대상 선택과 접속·작업 함수를 분리한다
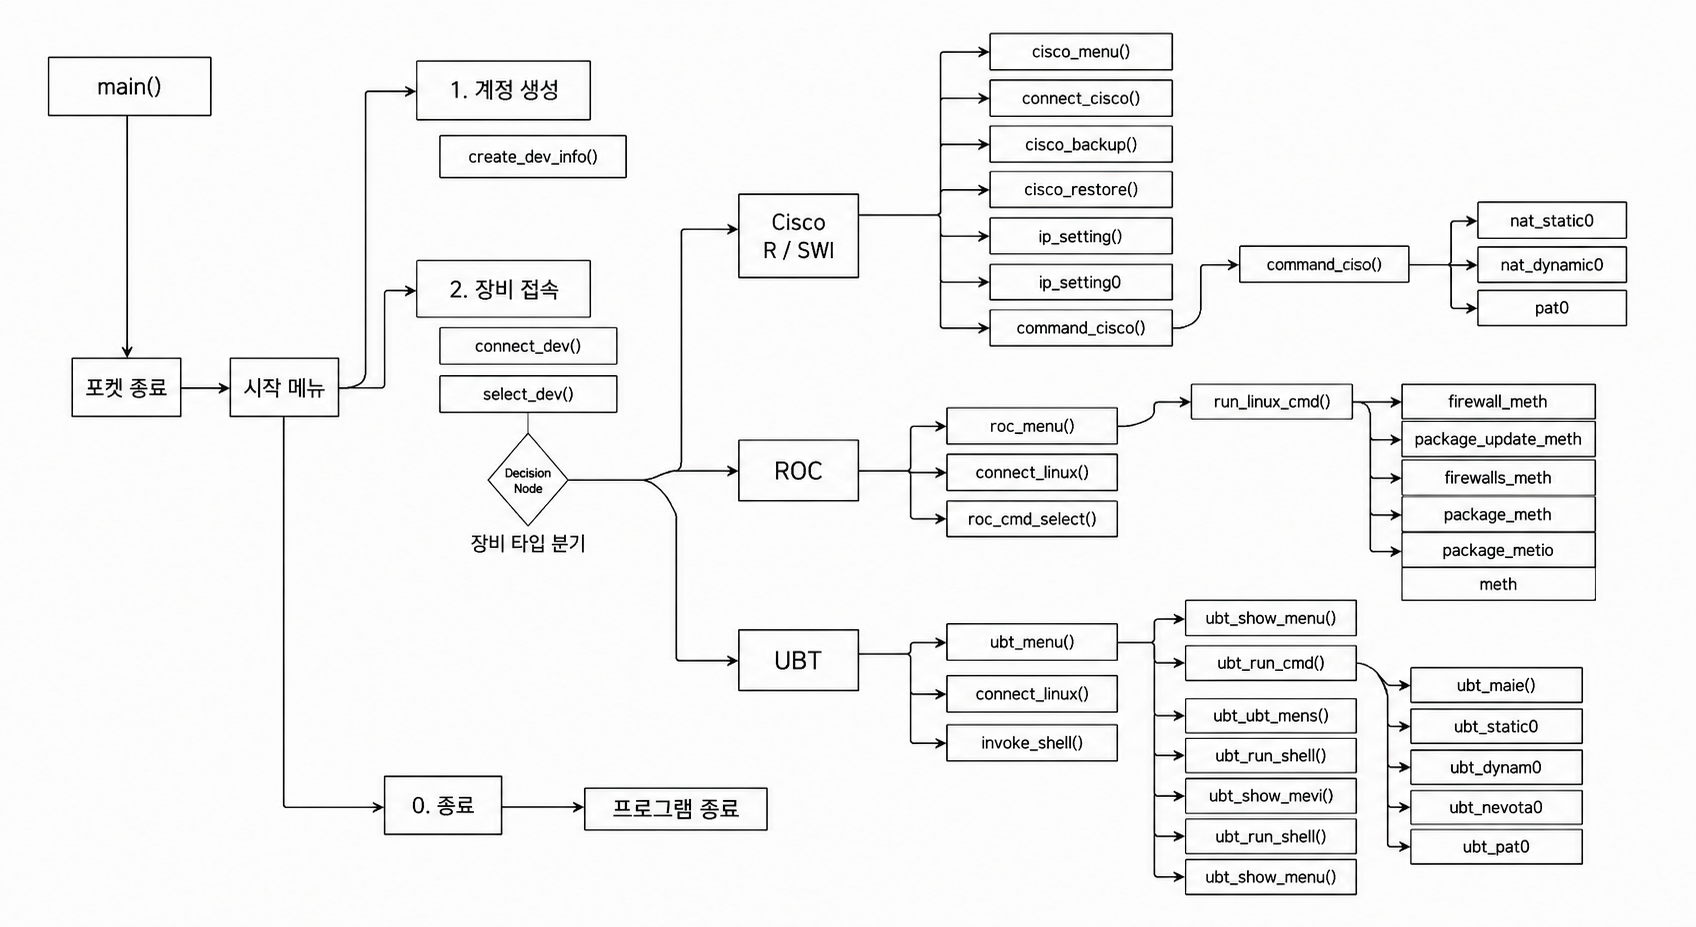
- 흐름도는 메뉴에서 장비 종류와 대상을 선택한 뒤 해당 접속 함수와 작업으로 분기한다. 사용자 입력이 그대로 임의 셸 명령으로 흘러가도록 만들지 않고 허용 작업으로 변환한다.
- 방식과 대화형 네트워크 CLI는 명령 완료를 판단하는 방법이 다르다. 장비 종류에 따라 채널 또는 의 프롬프트 처리를 선택한다.
 원본 크기로 보기 ↗
- 메인 메뉴에서 계정·장비 선택으로 분기하고 Cisco·Rocky·Ubuntu 등 대상 종류가 나뉜다.
- connect 함수와 설정 백업·invoke_shell 같은 작업 연결이 표현되어 있다.
확인 기준대상·인증·작업·저장 책임을 별도 함수로 나누고, 실패가 어느 단계에서 났는지 결과에 남긴다.
설정 문장 생성과 장비 적용을 구별한다
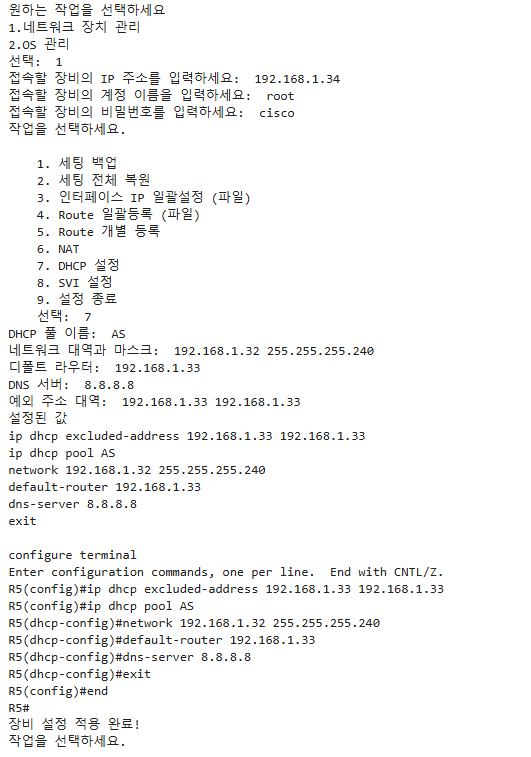
- 메뉴 사진은 입력을 받아 Cisco 설정 문장으로 바꾸고 장비 프롬프트와 완료 메시지를 출력한다. 입력값 검증과 명령 구성의 연결을 보여 준다.
- 프로그램이 찍은 적용 완료 문자열은 코드에서 정한 표시다. 장비 오류 응답, 실행 후 구성 조회, 실제 할당까지 확인해야 목적한 동작을 입증할 수 있다.
 원본 크기로 보기 ↗
- 사용자가 DHCP 관련 값을 입력하는 메뉴와 생성된 설정 문장이 보인다.
- 장비 CLI 프롬프트와 프로그램의 적용 완료 메시지가 이어지지만 실제 클라이언트 임대 결과는 이 화면에 없다.
확인 기준설정 성공 판정을 마지막 print문에 맡기지 않는다. 읽기 전용 사후 조회를 작업별로 정해 기대 상태와 비교한다.
SSH 조회의 출력과 종료 상태를 함께 수집한다
- 재구성 코드는 사전에 등록된 호스트 키를 확인하고 작은 조회 명령을 실행한다. stdout·stderr·종료 상태를 별도 값으로 보관해 명령 실패를 정상 자료와 구분한다.
- 큰 출력이나 대화형 세션은 채널 버퍼와 완료 판정 방식이 다르므로 아래 짧은 조회 예시를 그대로 확장하지 않는다. 접속 실패와 실행 후 연결 끊김도 별도 상태로 남겨야 한다.
from pathlib import Path
import paramiko

client = paramiko.SSHClient()
client.load_system_host_keys()
try:
    client.connect("192.0.2.30", username="labuser",
                   key_filename=str(Path.home() / ".ssh" / "lab_ed25519"),
                   timeout=5, auth_timeout=5, banner_timeout=5)
    stdin, stdout, stderr = client.exec_command("ip -brief address", timeout=10)
    out = stdout.read().decode("utf-8", errors="replace")
    err = stderr.read().decode("utf-8", errors="replace")
    rc = stdout.channel.recv_exit_status()
    print({"returncode": rc, "stdout": out, "stderr": err})
finally:
    client.close()
준비된 키·known_hosts를 사용하는 짧은 조회 재구성 예시다. 출력이 큰 작업에는 stdout·stderr를 함께 계속 소비하는 별도 수집기가 필요하다.
확인 기준rc=0은 해당 명령이 보고한 성공이다. 기대한 주소·인터페이스가 출력되는지까지 검증하고, 연결 끊김 뒤 결과가 불명확하면 설정 작업을 무조건 재시도하지 않는다.
결과 파일은 대상·시각·작업을 식별하게 저장한다
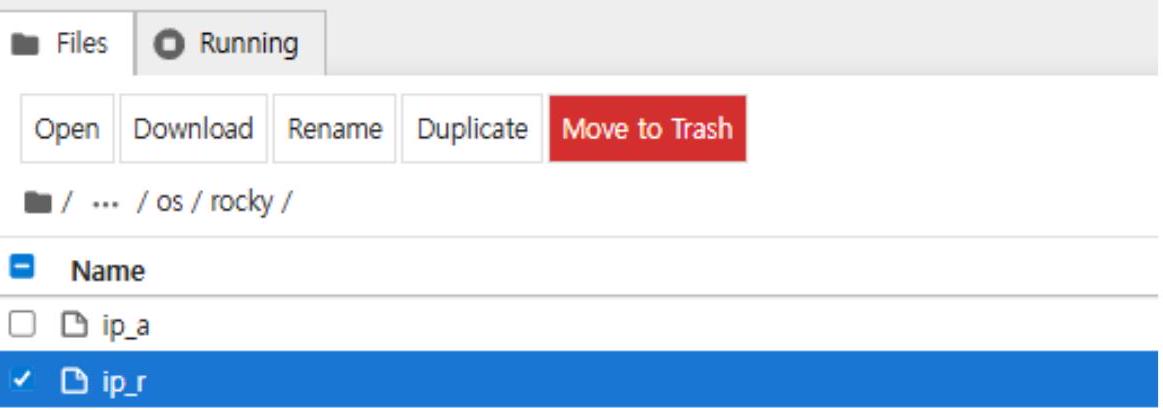
- Jupyter 화면에는 OS별 폴더 아래 ip_a·ip_r 같은 조회 결과 파일이 보인다. 파일이 만들어진 사실과 파일 내용이 유효한 결과라는 사실은 다르다.
- 대상 식별자, 수집 시각, 실행 명령, 종료 상태를 함께 저장하면 나중에 주소와 경로를 비교할 때 어떤 시스템의 관찰인지 복원할 수 있다.
 원본 크기로 보기 ↗
- Jupyter의 files/os/rocky/ 경로에 결과 파일들이 보인다.
- ip_a와 ip_r처럼 조회 작업을 구별하는 파일명이 나열된다.
확인 기준빈 파일·오류 문자열·다른 장비 결과 덮어쓰기를 구분한다. 공개 문서로 옮길 때 자격 정보와 민감 설정은 제외한다.
실습에서 확인한 동작 원리
- 자동화는 명령 전송만이 아니라 입력 검증·접속 신뢰·실행 결과 판정·근거 저장까지 연결하는 작업이다.
- CLI 프롬프트나 완료 문구 대신 종료 상태와 사후 조회로 실제 적용 결과를 확인한다.
04예제로 따라가기
- def add(x, items=[])의 기본 리스트는 인자를 생략한 호출 사이에 공유되므로 매 호출 빈 목록이 필요하면 None을 받아 본문에서 생성한다.
- 반복문에서 lambda: i를 세 번 만든 뒤 호출하면 마지막 바인딩 2를 함께 볼 수 있다. lambda i=i: i는 생성 시 값을 기본값에 보관한다.
- 함수 인자 items에 append하면 호출자의 리스트가 바뀌지만 items=[9]로 재대입한 것은 지역 이름 연결만 바꾼다.
05혼동하기 쉬운 점과 확인 기준
- 함수 안에서 x를 대입하는 문장이 있으면 선언이 없는 보통 경우 x는 지역 이름으로 분류된다. 대입 전에 print(x)를 하면 전역 x가 있어도 아직 지역 값이 없어 실패할 수 있다.
- f(1, a=2)처럼 같은 매개변수 a에 위치와 키워드 값을 동시에 주면 함수 본문 전에 TypeError가 난다. 함수 안의 계산 오류와 호출 바인딩 오류를 분리한다.
- yield가 있는 함수를 호출하면 generator 객체를 얻고 본문은 순회할 때 진행된다. 객체 생성이 성공했어도 next에서 파일·변환 예외가 생길 수 있다.
06상세 노트 · 실습 자료
헤더 구조, 설정 예시, 수치 계산과 수업 캡처는 아래 노트에서 이어집니다.
공식 문서 · 표준
기초 개념과 동작 설명을 대조한 자료입니다. 제품 버전과 실제 설정에 따른 차이는 본문 및 원문에서 확인하세요.