
MariaDB
마리아디비
는 에서 갈라져 발전한 관계형 DBMS로 과 여러 저장 엔진을 제공한다. 웹 애플리케이션의 자료를 관리하고 백업·복제 기능을 제공하지만 의 모든 버전과 완전히 같은 제품으로 취급하면 안 된다.
밑줄 용어에 마우스를 올리거나, 키보드로 선택하거나, 터치하면 설명을 볼 수 있습니다.
로고: MariaDB Foundation 공식 자료. 제품 식별을 위해 표시하며 각 상표의 권리는 권리자에게 있습니다.
01무엇이고, 어떤 일을 하나
- 테이블·인덱스·사용자 권한을 관리하고 을 실행한다.
- 엔진을 이용해 동시 변경과 복구를 처리한다.
- 와 물리 백업·변경 로그를 통해 복원 재료를 만든다.
02어떤 순서로 동작하나
- 요청 인증
접속 계정과 권한을 검사하고 사용할 데이터베이스와 객체를 해석한다.
- 실행
질의 계획과 저장 엔진에 따라 인덱스·페이지를 읽거나 변경한다.
- 성공 단위 확정
업무의 여러 변경을 으로 확정하거나 오류에 맞춰 취소한다.
- 보존·복원 준비
·일관성 방식·변경 로그 시작 위치를 기록하고 격리 환경에서 복원 가능성을 검증한다.
03먼저 알아둘 용어와 구성요소
- 의 와 의 mysqldump는 논리 백업 도구다.
- --single-은 주로 InnoDB 같은 테이블을 일관된 스냅샷으로 읽는 데 쓰인다.
- routines·events·triggers 같은 객체 포함 범위도 데이터 행과 별도로 선택한다.
- 는 복제와 시점 복구에 사용할 변경 스트림이다.
- 이후 변경 로그를 연속 보관하고 백업과 로그 시작 위치의 관계를 기록하면 지정 시점까지 변경을 다시 적용하는 을 구성할 수 있다. 예를 들어 오전 기본 백업 뒤 오후에 잘못된 삭제가 발생했다면 삭제 직전까지의 로그를 적용하는 목표를 세운다.
- 는 허용 가능한 데이터 손실 범위를 시간 등으로 표현하고 는 복구 완료까지 허용하는 시간을 뜻한다.
MariaDB 연결 성공 뒤 SQL 문법·선택 DB 상태 읽기
접속 성공, 구문 오류, 현재 DB, 전송 방식의 정보를 실제 클라이언트 출력에서 분리한다.
실습 구성과 전제
- 두 사진은 다른 세션·계정의 조회 결과다. 권한이 같은 한 세션의 연속 출력처럼 읽지 않는다.
- 실습 계정은 준비된 DB 서버의 최소 조회 권한을 사용한다. -p 뒤에 실제 암호를 붙여 명령 기록에 남기지 않는다.
로그인과 SQL 파싱을 구별한다
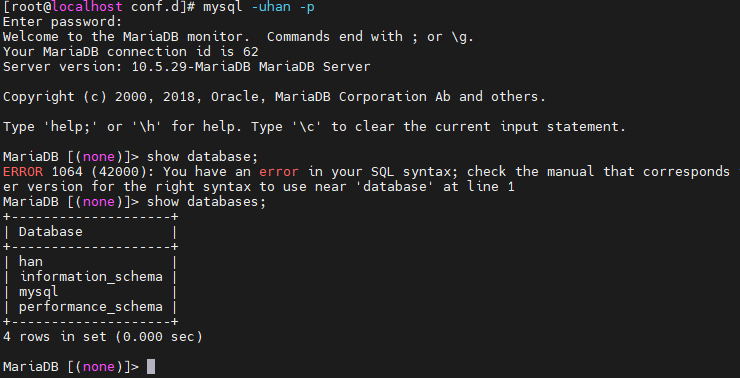
- 프롬프트까지 들어왔다는 것은 해당 연결의 인증이 완료되었다는 뜻이다. 그 뒤 show database의 ERROR 1064는 구문 단계에서 난 오류다.
- 복수형 SHOW DATABASES로 고치면 목록이 반환된다. 목록은 현재 계정이 볼 수 있는 DB 범위를 반영하므로 서버의 모든 DB가 반드시 보인다고 단정하지 않는다.
SHOW DATABASES;
SELECT VERSION(), CURRENT_USER(), DATABASE();
접속한 세션에서 서버 버전·권한 계정·선택 DB를 읽는 조회 예시다.
 원본 크기로 보기 ↗
- 로그인 후 MariaDB 프롬프트와 10.5.29 서버 버전이 표시된다.
- show database는 1064 오류를 내고 show databases는 네 행의 목록을 반환한다.
확인 기준구문 오류를 인증 실패로 처리하지 않는다. 서버 응답을 받은 시점과 실패한 문장을 함께 기록한다.
현재 데이터베이스와 접속 경로를 읽는다
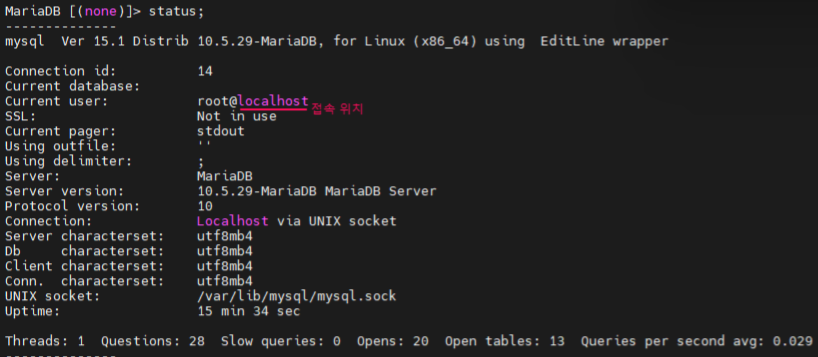
- status 화면에는 접속 사용자, 연결 방식, 문자 집합 등이 따로 나온다. Current database가 비어 있으면 기본 DB를 선택하지 않은 상태이며, 인증 실패가 아니다.
- 별도 사진은 UNIX 소켓 연결이므로 SSL Not in use를 곧바로 원격 구간의 평문 전송 증거로 해석하지 않는다. 전송 경로를 먼저 구분해야 한다.
 원본 크기로 보기 ↗
- Connection 항목은 Localhost via UNIX socket이고 Current database는 비어 있다.
- SSL Not in use와 여러 utf8mb4 문자 집합 항목이 각각 별도 행으로 보인다.
확인 기준현재 세션의 권한과 전송 방식을 확인한 뒤 결과를 해석한다. socket 접속과 접속은 계정 매칭·보안 조건이 달라질 수 있다.
스키마 선택 후 이름 해석을 확인한다
- 테이블 이름만 쓸 때는 현재 DB를 기준으로 찾는다. USE로 DB를 선택하거나 DB명.테이블명으로 명시하면 어떤 객체를 조회했는지 분명해진다.
- 목록 표시 권한, 테이블 읽기 권한, 테이블 존재 여부는 다르다. SELECT DATABASE()가 NULL인 경우에도 SELECT 1 같은 특정 DB에 의존하지 않는 질의는 실행될 수 있다.
SELECT DATABASE();
USE labdb;
SELECT DATABASE();
SHOW TABLES;
labdb는 준비한 실습 DB 이름이다. 출력은 실제 실행 세션에서 확인한다.
확인 기준재구성한 labdb가 실제 준비된 경우에만 USE를 적용한다. Unknown database·table does not exist·access denied를 서로 다른 원인으로 분류한다.
실습에서 확인한 동작 원리
- 접속 성공 뒤에도 문법, 객체 선택, 개별 권한 단계에서 각각 오류가 발생한다.
- 현재 DB와 연결 방식은 status·DATABASE() 같은 명시적 조회로 확인하며 화면 하나의 성공을 확대하지 않는다.
동작·명령 참고 문서
복제 수신과 적용 스레드가 서로 다른 상태가 되는 과정
복제 상태의 Connecting·Yes·No와 로그 위치· 오류를 연결해 중단 지점을 설명한다.
실습 구성과 전제
- 사진은 의 SHOW SLAVE STATUS 형식이다. 현재 버전에서는 REPLICA 용어의 별칭을 제공할 수 있으나 화면의 필드 이름으로 해석한다.
- 세 상태를 수신→적용의 역할에 맞춰 비교한다. 암호·원본 서버 주소·발급된 자격 정보는 본문에 재현하지 않는다.
수신 연결이 아직 성립하지 않은 상태를 읽는다
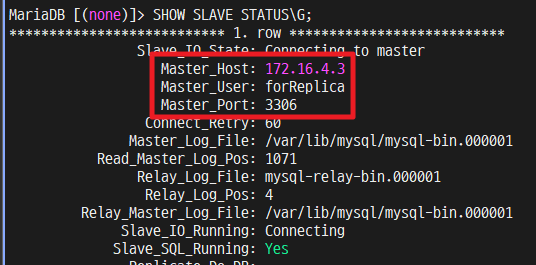
- IO 스레드는 원본 서버의 변경 로그를 받아 relay log로 저장하고 스레드는 받은 이벤트를 적용한다. 두 상태 필드는 서로 다른 작업의 진행 여부다.
- IO가 Connecting이고 이 Yes이면 적용 스레드가 동작해도 새 변경을 정상 수신 중이라고 할 수 없다. 접속·인증·로그 파일 위치 문제는 IO 오류와 함께 확인해야 한다.
SHOW SLAVE STATUS\G화면과 같은 구문이다. 세로 출력에서 수신·적용 상태와 마지막 오류를 구분한다.
 원본 크기로 보기 ↗
- Slave_IO_Running은 Connecting, Slave_SQL_Running은 Yes다.
- Read_Master_Log_Pos=1071과 Relay_Log_Pos=4가 보이며 같은 종류의 위치 값이 아니다.
확인 기준두 필드 중 하나만 Yes인 상태를 복제 정상으로 요약하지 않는다. 마지막 IO 오류와 지연·로그 위치도 함께 읽는다.
연결 뒤 정상 대기 상태를 확인한다
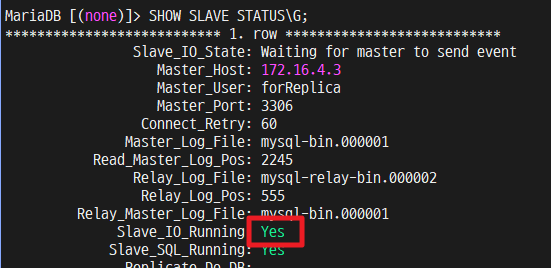
- 다음 화면은 두 스레드가 Yes이며 IO 상태가 원본의 새 이벤트를 기다리는 상태다. 네트워크 수신과 적용 작업이 모두 실행 가능한 단계임을 보여 준다.
- Read_Master_Log_Pos와 Relay_Log_Pos는 서로 다른 로그 좌표이므로 숫자를 빼서 지연 바이트로 계산하지 않는다. 적용 완료 위치와 원본 위치도 파일명·좌표 체계를 맞춰 비교한다.
 원본 크기로 보기 ↗
- Slave_IO_Running=Yes, Slave_SQL_Running=Yes가 함께 보인다.
- Slave_IO_State는 새 이벤트를 기다리는 문구이고 Read_Master_Log_Pos=2245, Relay_Log_Pos=555가 표시된다.
확인 기준Yes/Yes만으로 모든 테이블의 일치나 영구 무지연을 보장하지 않는다. 업무 데이터 검증과 적용 좌표를 별도로 확인한다.
수신은 계속되지만 SQL 적용이 멈춘 상태를 해석한다
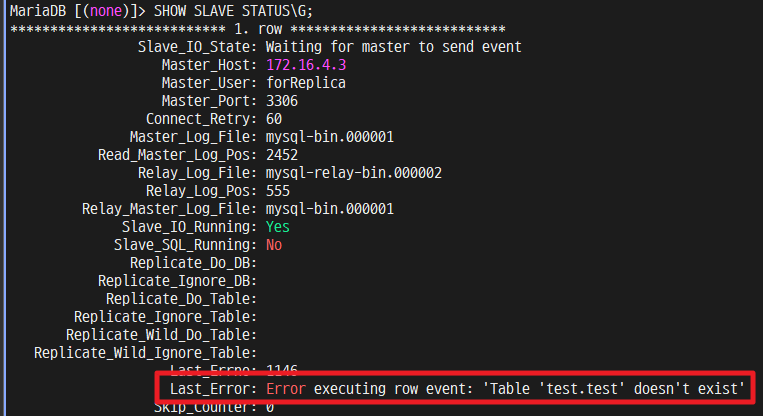
- 마지막 화면은 IO Yes· No다. 변경 로그를 계속 받을 수 있어도 누락된 test.t1 테이블에 이벤트를 적용하지 못해 스레드가 중단된다.
- 초기 데이터와 복제 시작 좌표가 일치해야 한다. 오류를 무조건 건너뛰면 정합성 차이를 숨길 수 있으므로 기본 백업·스키마·실패 이벤트의 관계를 복원해야 한다.
 원본 크기로 보기 ↗
- Slave_IO_Running=Yes인데 Slave_SQL_Running=No로 바뀐다.
- Last_SQL_Errno=1146과 test.t1이 존재하지 않는다는 오류가 표시된다.
확인 기준오류 원인을 해결한 뒤 스레드 상태뿐 아니라 누락 데이터·스키마를 대조한다. 복제본에도 삭제와 잘못된 변경이 전파될 수 있어 독립 백업이 필요하다.
실습에서 확인한 동작 원리
- 복제 수신과 적용은 별도 작업이므로 IO 상태· 상태·마지막 오류를 같이 읽는다.
- 기본 데이터와 시작 좌표의 일치가 복제의 전제이며, 복제 성공은 시점 복구용 백업을 대체하지 않는다.
동작·명령 참고 문서
04예제로 따라가기
- 행 데이터가 덤프됐어도 필요한 routines·events·triggers 포함 여부가 다르면 애플리케이션 기능이 완전히 복원되지 않을 수 있다.
- 백업 도중 DDL이나 비트랜잭션 테이블 쓰기가 있다면 single- 옵션만으로 전체 구조의 일관성을 보장하지 못할 수 있다.
- 마지막 백업 이후 로그 구간 하나가 빠지면 이후 로그가 남아 있어도 원하는 시점까지 연속 재생하지 못할 수 있다.
05혼동하기 쉬운 점과 확인 기준
- 실행 중인 데이터 디렉터리를 파일 복사 도구로 단순 복사하면 각 파일을 읽은 시점이 달라질 수 있다.
- 파일 권한, 성공 종료 상태, 저장 장치 보존과 복원 가능성까지 이어져야 백업 작업이 된다.
- 기존 설명을 사용할 때 명령 이름뿐 아니라 대상 버전·엔진·옵션 지원을 구분해야 한다.
06상세 노트 · 실습 자료
헤더 구조, 설정 예시, 수치 계산과 수업 캡처는 아래 노트에서 이어집니다.
공식 문서 · 표준
기초 개념과 동작 설명을 대조한 자료입니다. 제품 버전과 실제 설정에 따른 차이는 본문 및 원문에서 확인하세요.